DORA 는 AI 가 조직의 강점과 약점을 그대로 증폭한다며 일곱 가지 역량을 조건으로 꼽았고 Karpathy 는 "생각은 맡길 수 있어도 이해는 맡길 수 없다"고 했습니다. 조직이 갖춰야 할 조건과 개발자 개인이 키워야 할 역량을 DORA·Microsoft·Stack Overflow 자료로 정리했습니다.
같은 도구를 썼는데 팀마다 결과가 다른 이유
같은 회사에서 같은 에이전트를 배포했는데 어떤 팀은 PR 이 두 배가 되고 어떤 팀은 리뷰 대기만 늘어납니다. 도구 문제가 아니라면 뭘까요? DORA 의 2025년 보고서가 이 질문에 답을 냈습니다. 약 5,000명을 조사했더니 90% 가 AI 를 쓰고 있었는데 성과는 갈렸습니다. 결론은 AI 는 증폭기라는 겁니다. 잘 돌아가는 팀은 더 잘 돌아가고 문제가 있던 팀은 문제가 더 커집니다.
그래서 DORA 는 AI 의 효과를 키우는 조직 역량 일곱 가지를 따로 모델로 만들었습니다.
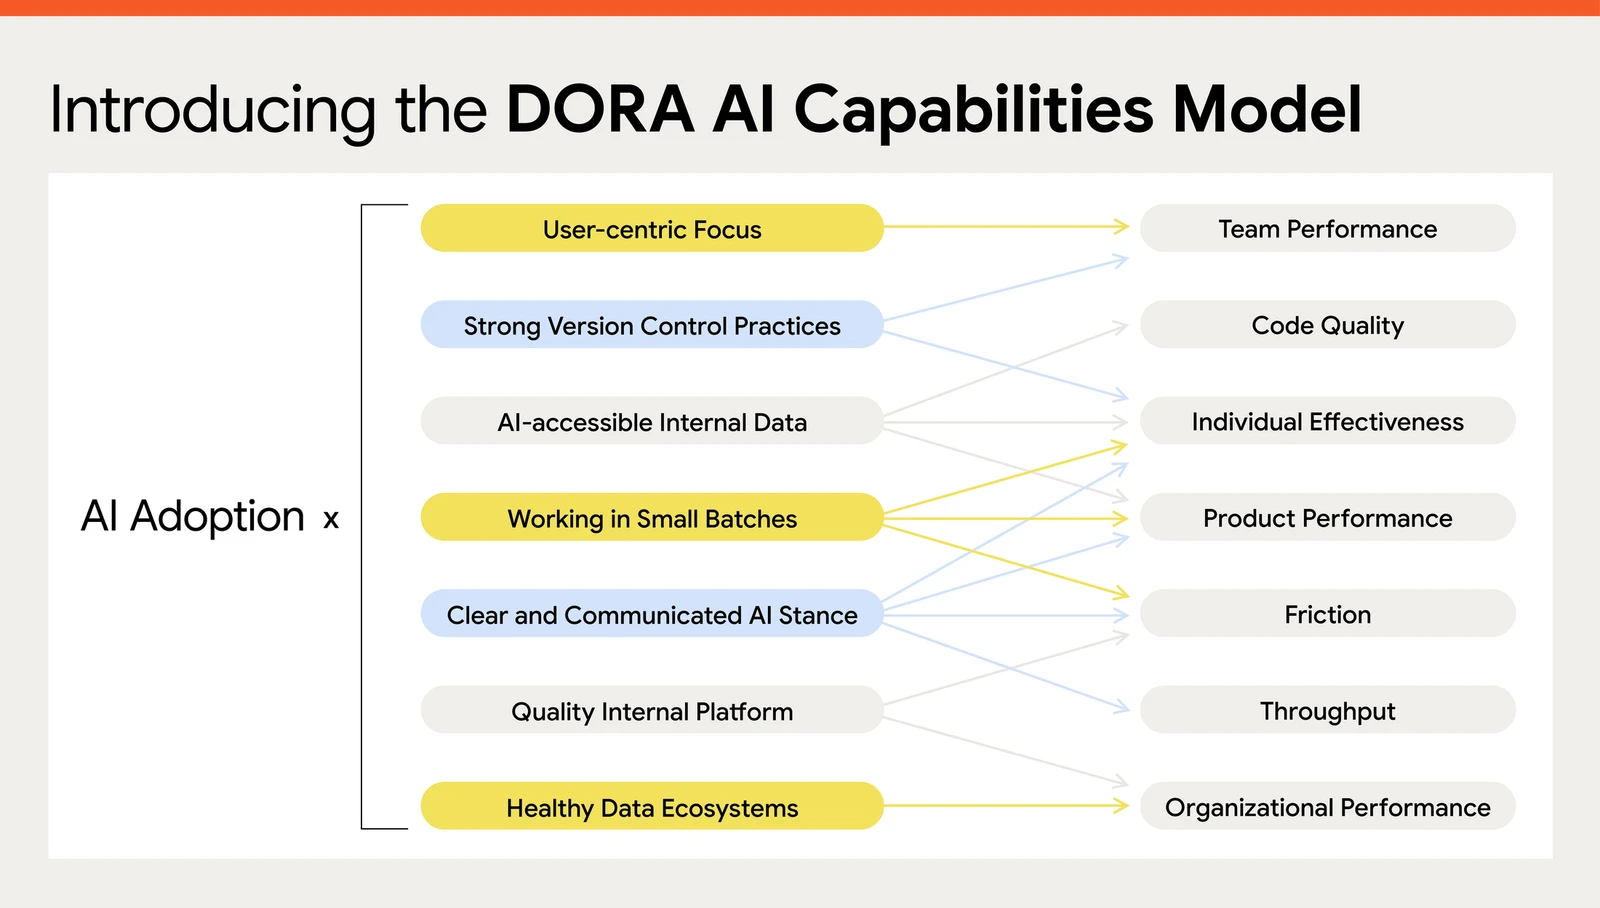
| 역량 | 개발 현장에서의 모습 |
|---|---|
| 명확히 공유된 AI 방침 | 어떤 도구를 어디까지 써도 되는지 |
| 건강한 데이터 생태계 | 문서·코드가 정리돼 있어야 에이전트가 읽는다 |
| AI 가 접근 가능한 내부 데이터 | MCP 로 내부 시스템을 연결 |
| 강한 버전 관리 관행 | 에이전트가 만든 변경을 되돌릴 수 있어야 한다 |
| 작은 배치로 일하기 | 시간·일 단위 작업, 작은 PR |
| 사용자 중심 | 무엇을 만들지 정하는 건 여전히 사람 |
| 품질 좋은 내부 플랫폼 | 테스트·CI·샌드박스가 검증 루프의 바탕 |
일곱 개 중 AI 전용은 셋뿐이고 나머지는 DevOps 시절부터 있던 기본기입니다. Thoughtworks 가 2026년 4월 Technology Radar 에서 "기본기로 돌아가라"고 한 것과 같은 결론입니다.
DORA 의 ROI 계산
경영진을 설득하려면 숫자가 필요합니다. DORA 가 2026년 4월 22일에 낸 ROI 보고서는 계산 틀을 줍니다. 예시로 든 엔지니어 500명, 평균 연봉 17만 6천 달러 조직에서 첫해 투자 840만 달러, 회수 1,160만 달러, ROI 39%, 회수 기간 약 8개월입니다.
다만 보고서 자체가 J 커브를 전제로 깝니다. 초기에는 학습 곡선, AI 코드를 검토하는 검증 비용, 늘어난 코드량을 받아 낼 테스트·승인 절차 조정 때문에 생산성이 떨어집니다. 보고서가 인용한 Stanford 연구에서는 새 프로젝트에서는 35~40% 향상이 나왔지만 복잡한 레거시 코드에서는 10% 안팎에 그쳤습니다. AI 가 만든 PR 이 리뷰를 4.6배 오래 기다린다는 LinearB 의 수치가 바로 이 검증 비용입니다. 병목을 예상하고 리뷰 자동화와 리스크 티어링을 먼저 준비한 조직이 J 커브의 바닥을 얕게 지납니다.
도입은 공지가 아니라 옆자리에서 퍼진다
조직 차원에서 또 하나 배울 게 있습니다. Microsoft 가 2026년 초 배포 결과를 분석한 연구(arXiv 2607.01418)입니다. 수만 명에게 Claude Code 와 Copilot CLI 를 열어 줬을 때 누가 써 봤을까요? 같은 직급의 동료가 이미 쓰고 있으면 시도할 확률이 216% 높았습니다. 공식 채널보다 사회적 경로가 강했습니다.
계속 쓰는 사람은 누구였을까요? 직급이나 연차보다 원래 코딩 활동량이 결정했습니다. 배포 전 주당 PR 2개 이상이던 엔지니어가 계속 쓸 확률이 31% 높았습니다. 효과는 주니어와 장기 근속자에게 더 컸습니다. 주니어는 발판으로, 장기 근속자는 병렬 작업 관리로 서로 다르게 썼습니다. 그리고 주당 5일 이상 쓴 주에는 안 쓴 주보다 머지 PR 이 50.1% 많았습니다. 논문의 결론은 한 줄입니다. "눈에 보이는 동료의 사용"을 배포 전략의 중심에 두라.
목줄을 쥔 단일 에이전트가 2026년 현장의 모습
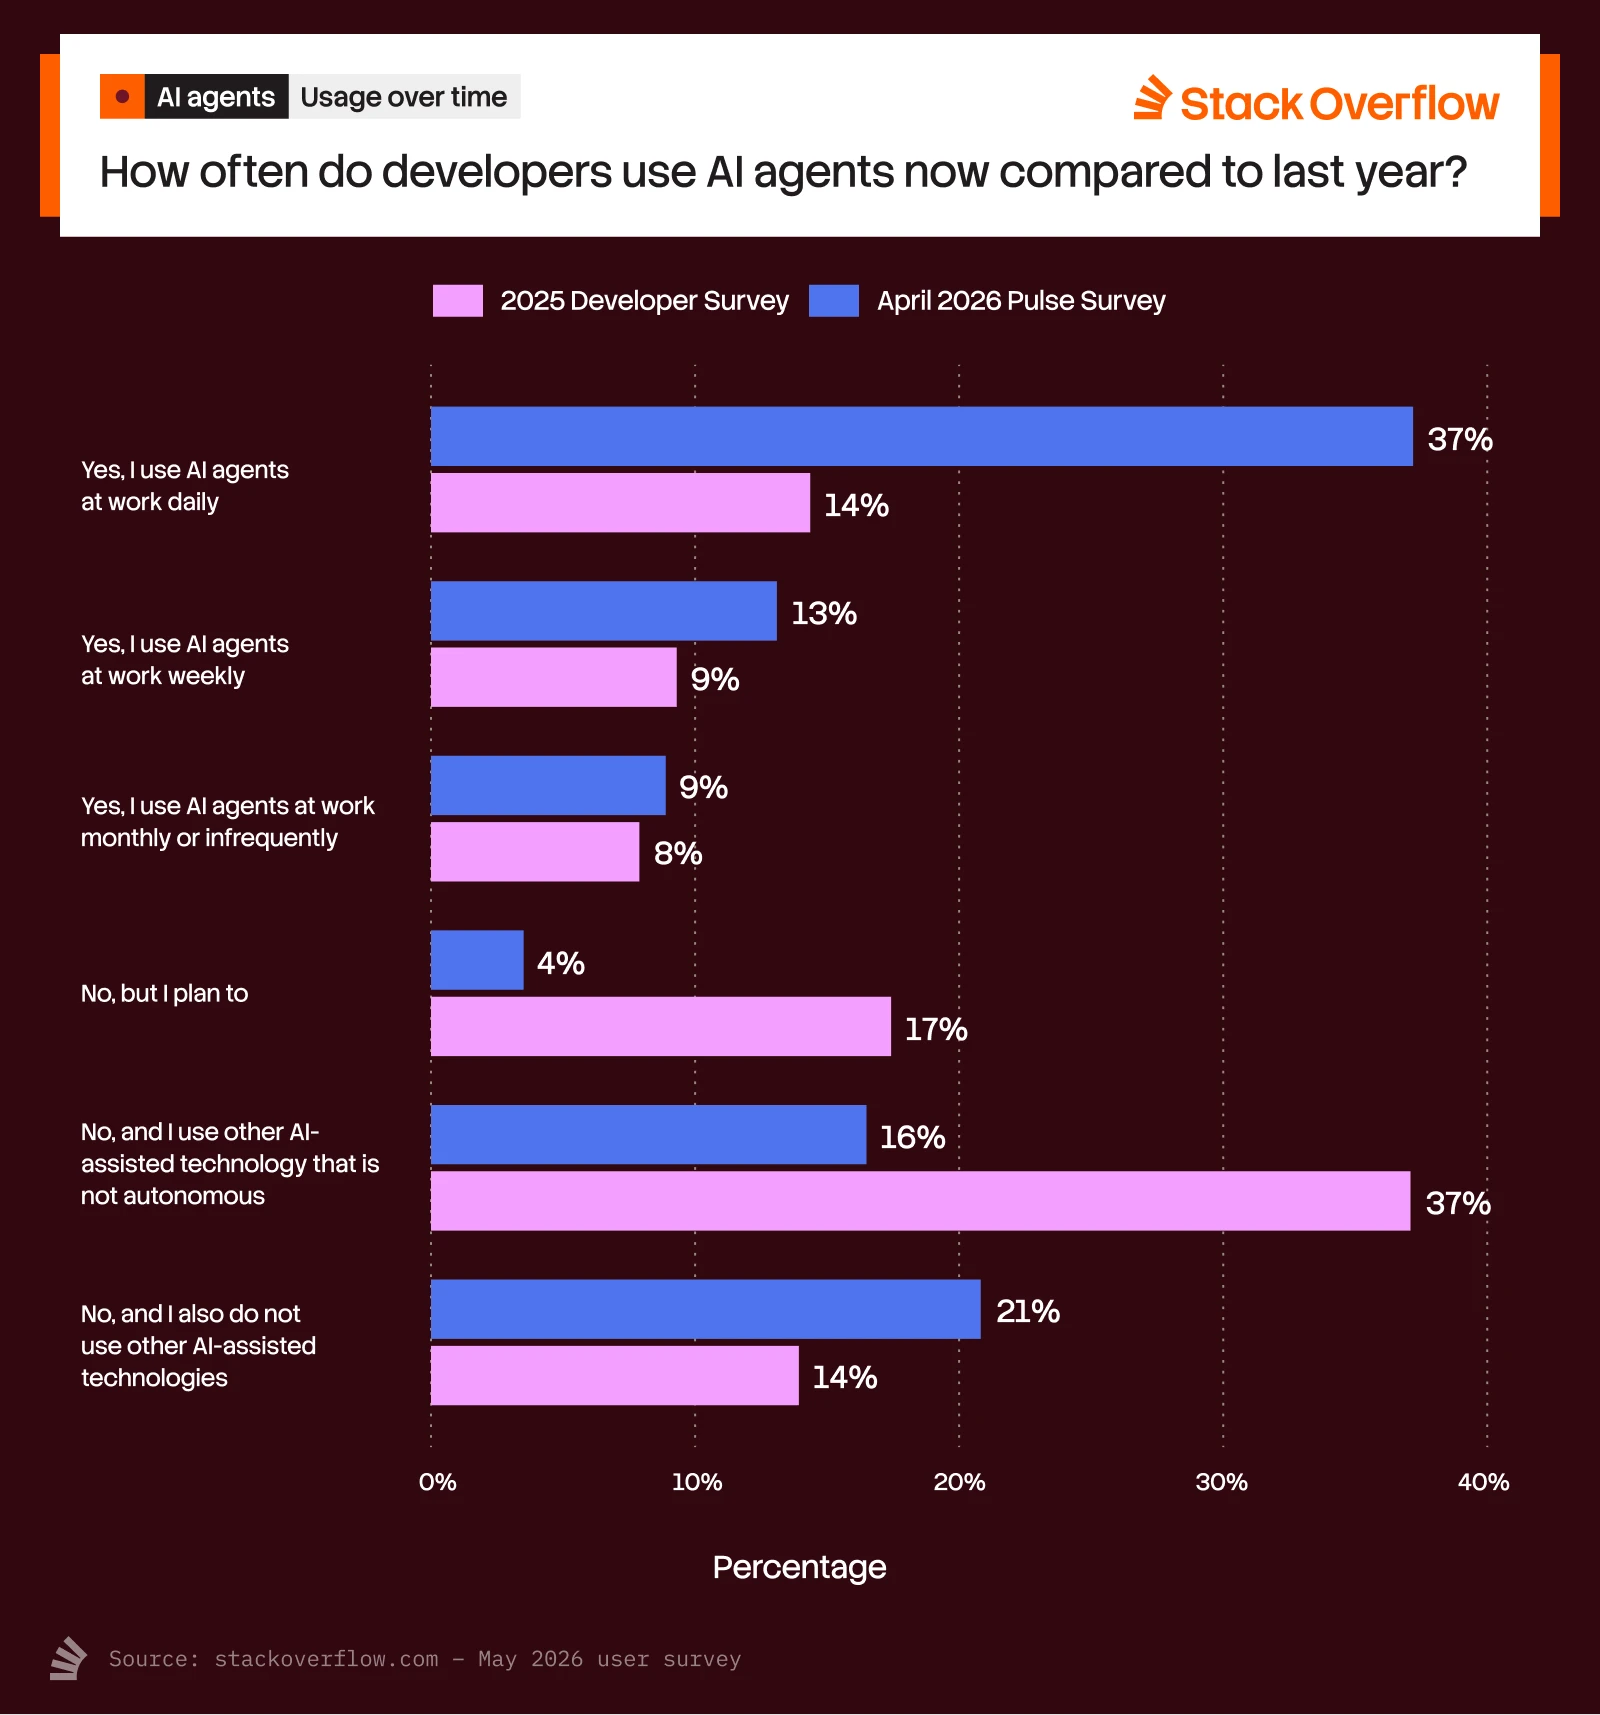
멀티 에이전트가 화제지만 현장은 아직 단순합니다. Stack Overflow 의 2026년 4월 조사입니다.
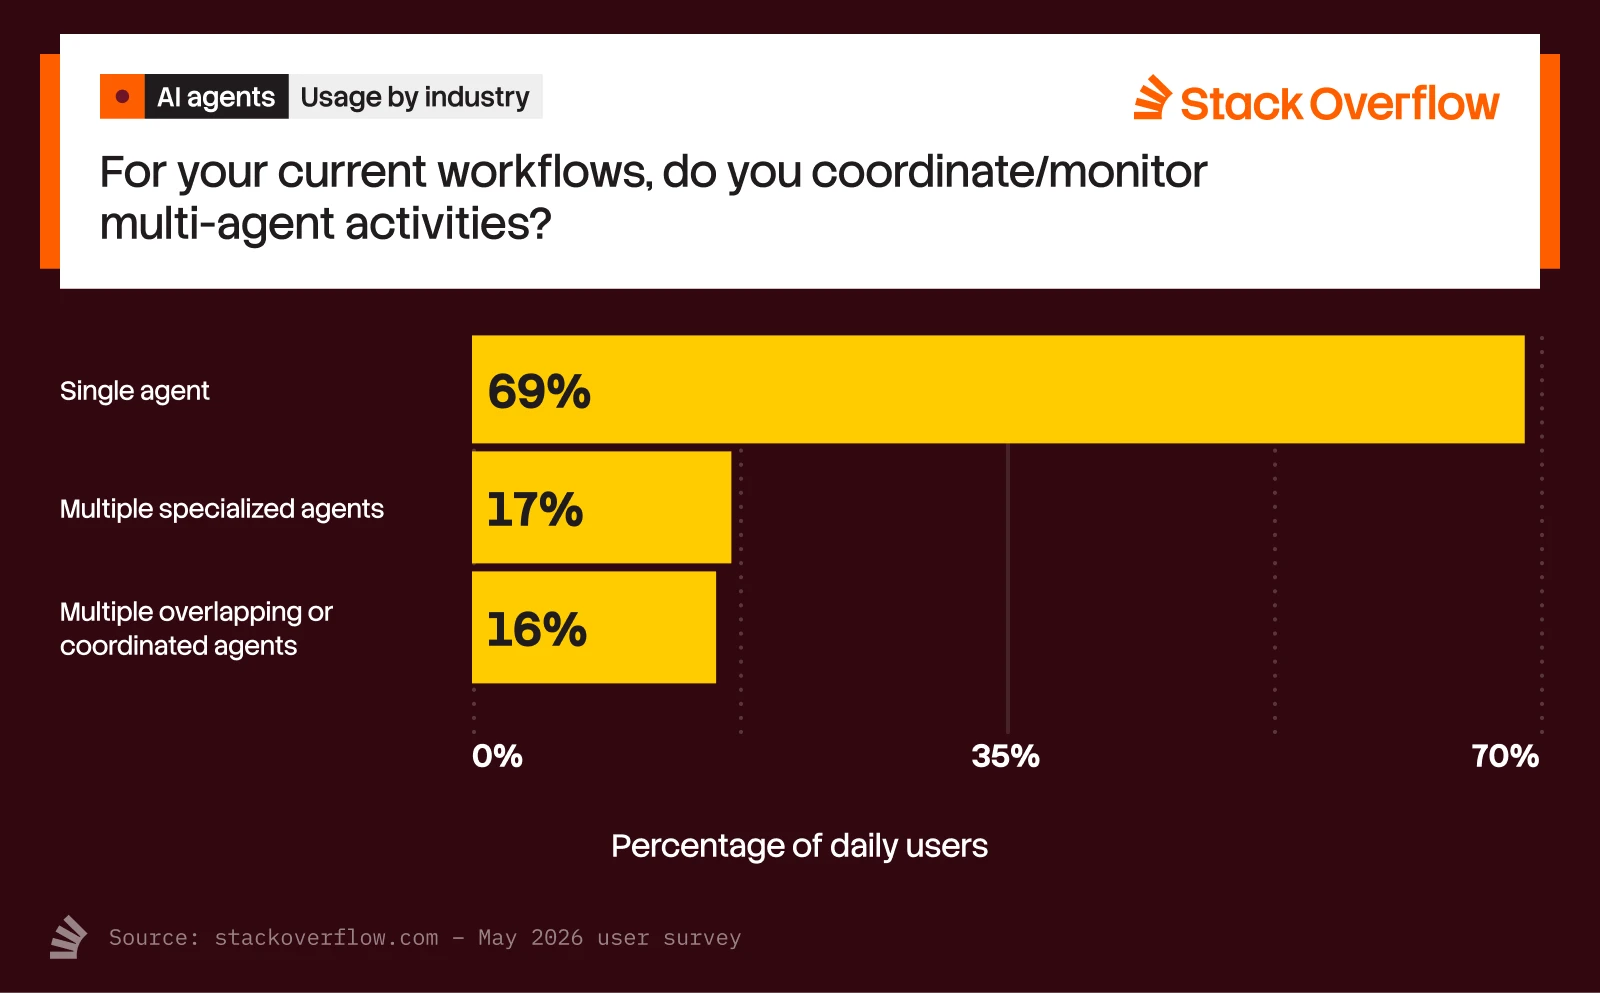
매일 쓰는 사람의 69% 가 에이전트 하나로 일합니다. 여러 에이전트를 조율한다는 응답은 16% 입니다. 63% 는 에이전트를 완전 자동으로 두는 일이 거의 없다고 했습니다. Stack Overflow 는 이 상태를 "목줄에 묶인 에이전트"라고 이름 붙였습니다. 매일 쓰는 비율은 직군별로 시니어 아키텍트 52%, 임원 50%, 풀스택 40% 순이었습니다. 코드를 가장 많이 치는 직군보다 방향을 정하는 직군이 먼저 매일 쓰고 있다는 게 눈에 띕니다.
Anthropic 은 그 끝에 있습니다. 엔지니어당 분기별 코드 출하량이 2021~2025년 대비 8배, 머지의 절반 이상이 내부 Claude 봇을 통해 이뤄지고 엔지니어는 방향 제시와 승인에 집중합니다. 대부분의 조직은 아직 그 사이 어디쯤입니다.
개발자 개인은 무엇을 키워야 하나
조직 이야기를 했으니 개인으로 내려오겠습니다. Karpathy 의 2026년 4월 Sequoia 대담이 가장 정리된 답을 줍니다. 그가 지금 더 중요해졌다고 꼽은 것들입니다.
- 취향과 판단 — 무엇이 만들 가치가 있는지, 결과가 수상한지 알아보는 감각
- 스펙 작성과 시스템 설계 — 요구사항과 스펙은 여전히 사람의 일
- 기저 개념의 이해 — 텐서가 어떻게 저장되고 메모리가 어떻게 쓰이는지 같은 원리
- 평가 루프 설계 — 에이전트가 스스로 돌릴 검증을 만드는 능력
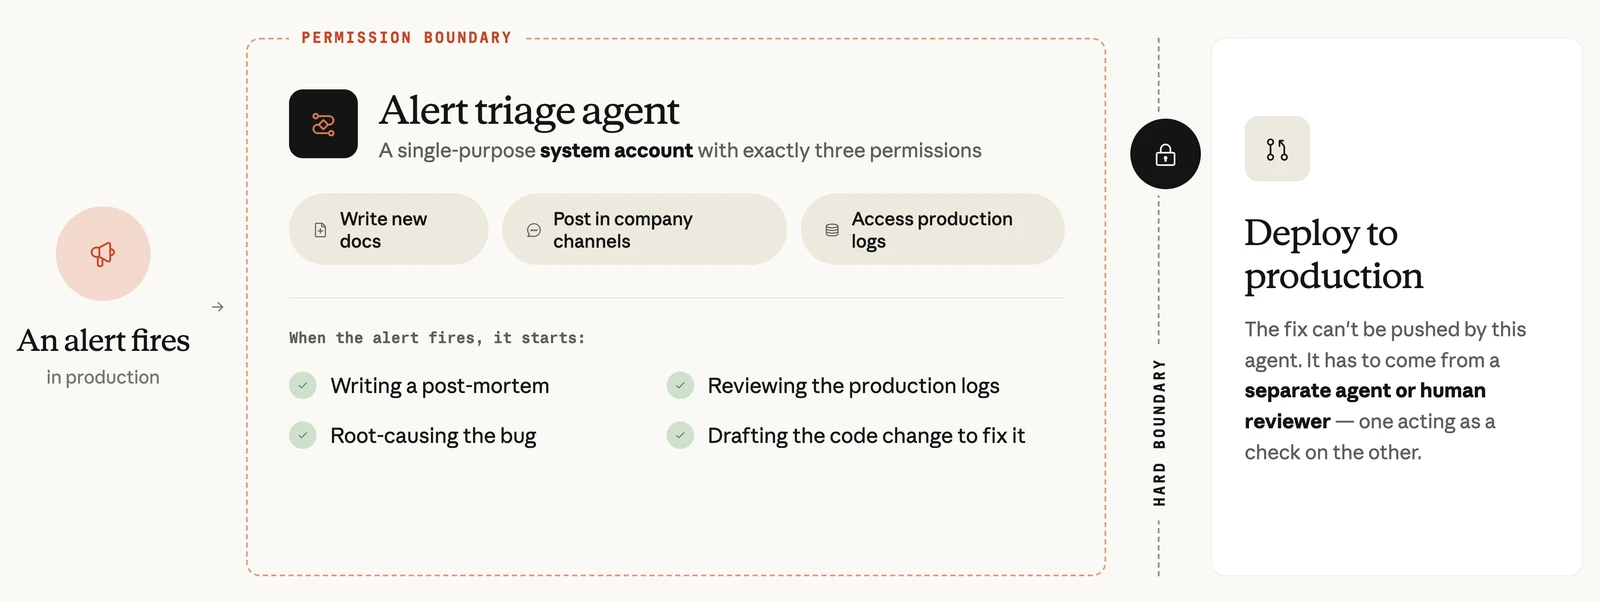
- 보안 감독 — 권한 경계와 승인 게이트를 정하는 일
그가 든 실패 사례가 이 목록의 이유를 설명합니다. 자기 앱 MenuGen 의 결제에서 에이전트가 Stripe 이메일과 Google 계정 이메일을 같은 것으로 매칭해 버그가 났습니다. 둘이 근본적으로 다르다는 건 시스템을 이해한 사람만 알 수 있습니다. 그래서 그의 문장이 이렇습니다. "생각은 맡길 수 있어도 이해는 맡길 수 없다." Thoughtworks 가 말한 인지 부채도 같은 경고입니다. 에이전트가 만든 코드를 이해하지 않고 쌓으면 어느 순간 아무도 시스템을 모르게 됩니다.
저 자신에게 적용하면 이렇게 정리됩니다. 문법과 API 암기는 놓아도 됩니다. 대신 "이 기능의 인수 조건을 테스트로 적을 수 있는가", "이 diff 가 왜 맞는지 설명할 수 있는가", "이 에이전트에게 준 권한이 왜 그만큼인지 말할 수 있는가"에 답할 수 있어야 합니다.
시리즈를 닫으며
시리즈 전체를 한 문장으로 줄이면 이렇습니다. 에이전트가 실행하고 사람이 명세·검증·통제를 맡는 구조가 2026년의 개발이고 그 구조를 운영하는 데 필요한 지식은 루프·방법론·스펙·컨텍스트·MCP·스킬·검증·보안·모델 위치·조직 역량 열 가지입니다. 도구 이름은 내년에 바뀔 겁니다. 그러나 "검증할 수 있는 것을 자동화한다"는 원리와 "이해는 맡길 수 없다"는 한계는 그대로일 겁니다. 이 시리즈가 그 둘 사이에서 자기 위치를 정하는 데 도움이 됐으면 합니다.
참고 자료
- Announcing the 2025 DORA Report — Google Cloud Blog — AI 역량 모델 도식 출처
- 2025 DORA AI Capabilities Model (PDF)
- ROI of AI-assisted Software Development — DORA (2026-04-22) / InfoQ 정리 (2026-05)
- Adoption and Impact of Command-Line AI Coding Agents: Microsoft's Early 2026 Rollout — arXiv 2607.01418
- Agents on a leash — Stack Overflow (2026-05-27) — 단일·다중 에이전트 도표 출처
- Sequoia Ascent 2026 summary — Andrej Karpathy
- How Anthropic secures its AI-native software development lifecycle — Anthropic (2026-07-21)