최근 글
모두 보기 →AI 네이티브 시대에 개발자가 배워야 할 것
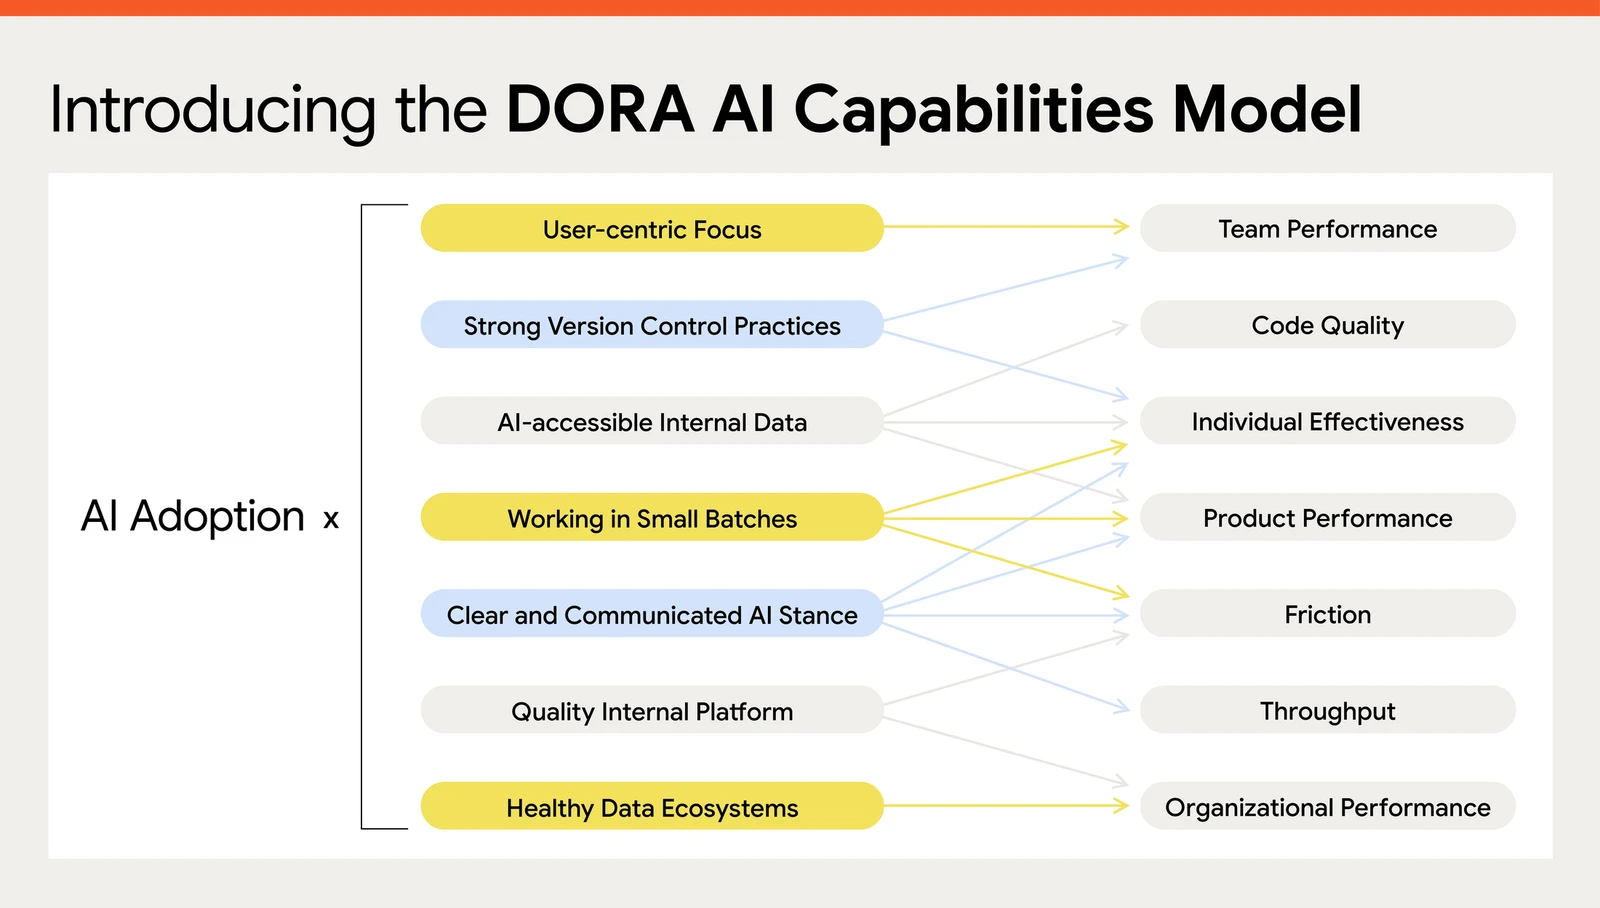
DORA 는 AI 가 조직의 강점과 약점을 그대로 증폭한다며 일곱 가지 역량을 조건으로 꼽았고 Karpathy 는 "생각은 맡길 수 있어도 이해는 맡길 수 없다"고 했습니다. 조직이 갖춰야 할 조건과 개발자 개인이 키워야 할 역량을 DORA·Microsoft·Stack Overflow 자료로 정리했습니다.
Orca 대신 Paseo 를 고르는 이유
에이전트를 여러 개 동시에 실행하는 도구가 올해 두 갈래로 나뉘었습니다. Orca 는 데스크톱 앱 안에 브라우저·에디터·터미널을 전부 넣었습니다. Paseo 는 반대로 화면을 빼고 데몬 하나만 남겼습니다. GitHub Star 는 Orca 가 6만 7천, Paseo 가 1만 7천으로 네 배 가까이 차이 납니다. 그래도 고를 때 봐야 할 건 Star 수가 아니라 내 작업이 어디서 끝나느냐입니다.
sLLM 자체 구축, 정말 대세일까요?
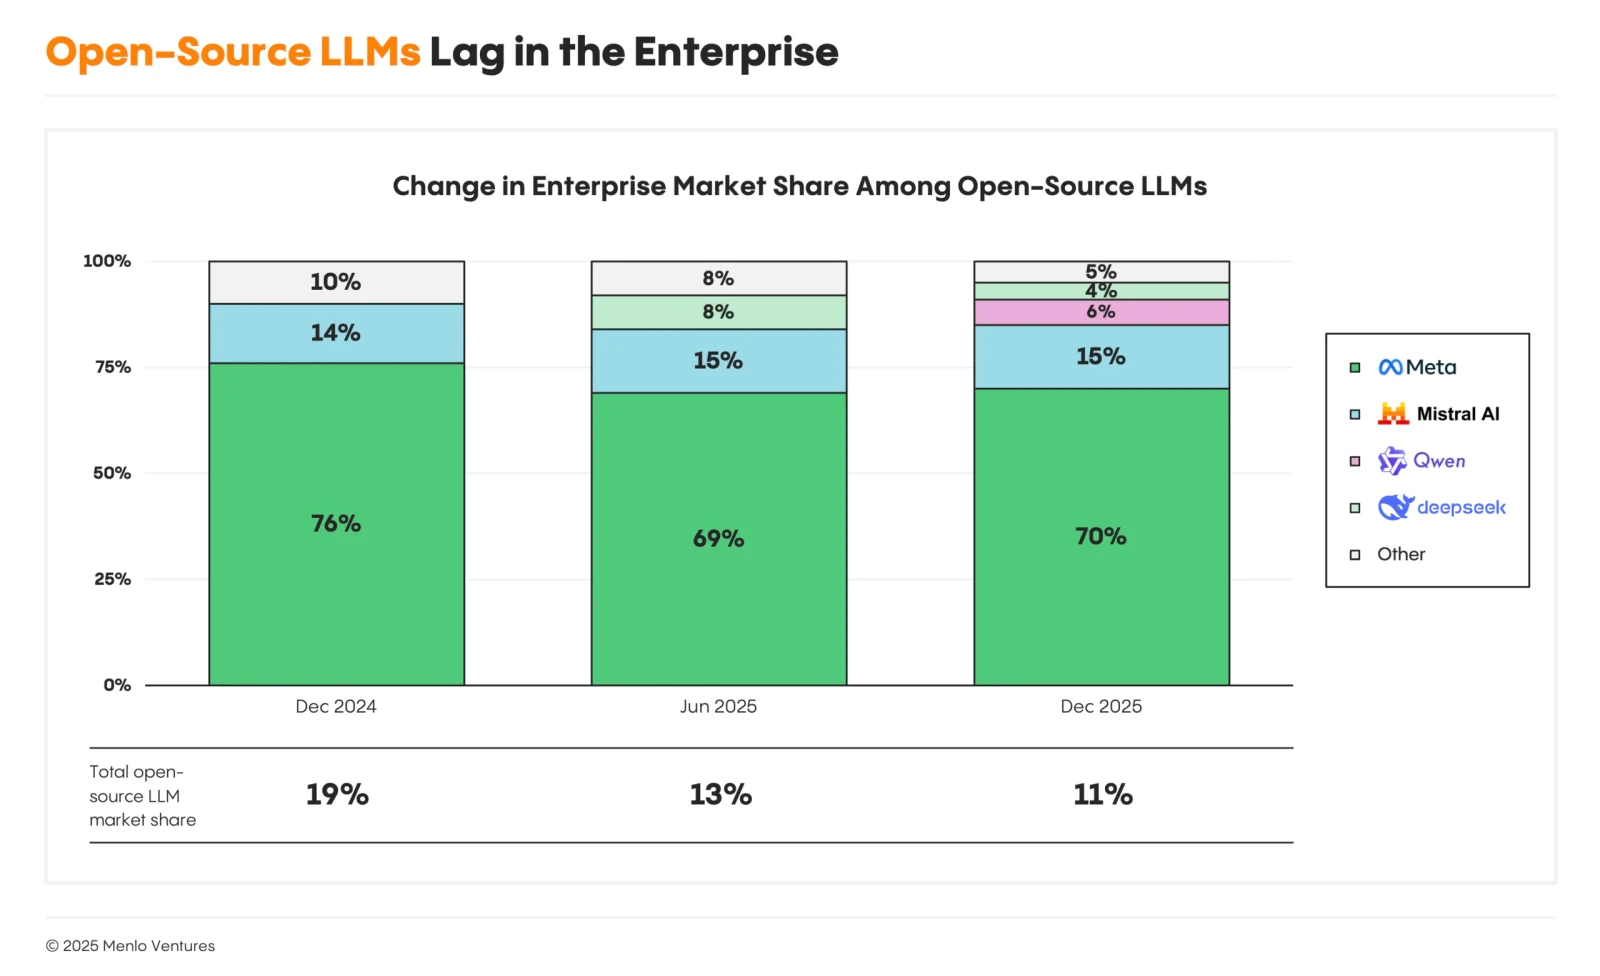
국내는 폐쇄망 규제와 정부의 독자 AI 파운데이션 모델 사업이 겹쳐 sLLM 자체 구축이 흐름이 됐는데, Menlo Ventures 가 집계한 세계 기업의 LLM 사용량에서 오픈소스 비중은 19% 에서 11% 로 줄었습니다. 두 숫자가 엇갈리는 이유와 코딩 에이전트에 붙일 수 있는 2026년의 오픈 웨이트 모델을 정리했습니다.
코딩 에이전트는 새로 입사한 직원처럼 다뤄야 한다
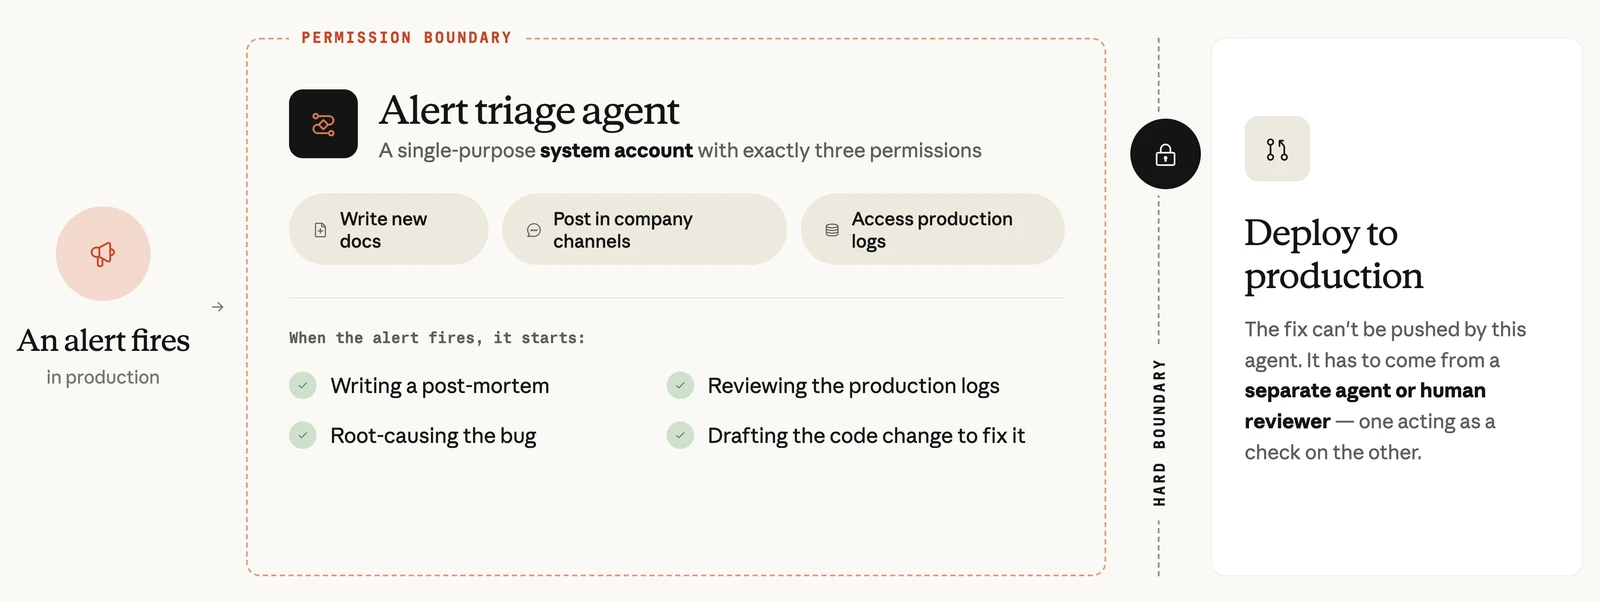
OWASP 는 2025년 12월에 에이전트 전용 Top 10 을 따로 냈고 Anthropic 은 내부 에이전트를 내부자 위협으로 취급해 감시합니다. 코딩 에이전트의 공격 표면과 샌드박스·권한 경계·감시·되먹임 네 층의 방어를 정리했습니다.
AI가 짠 PR은 왜 리뷰를 4.6배 오래 기다릴까?
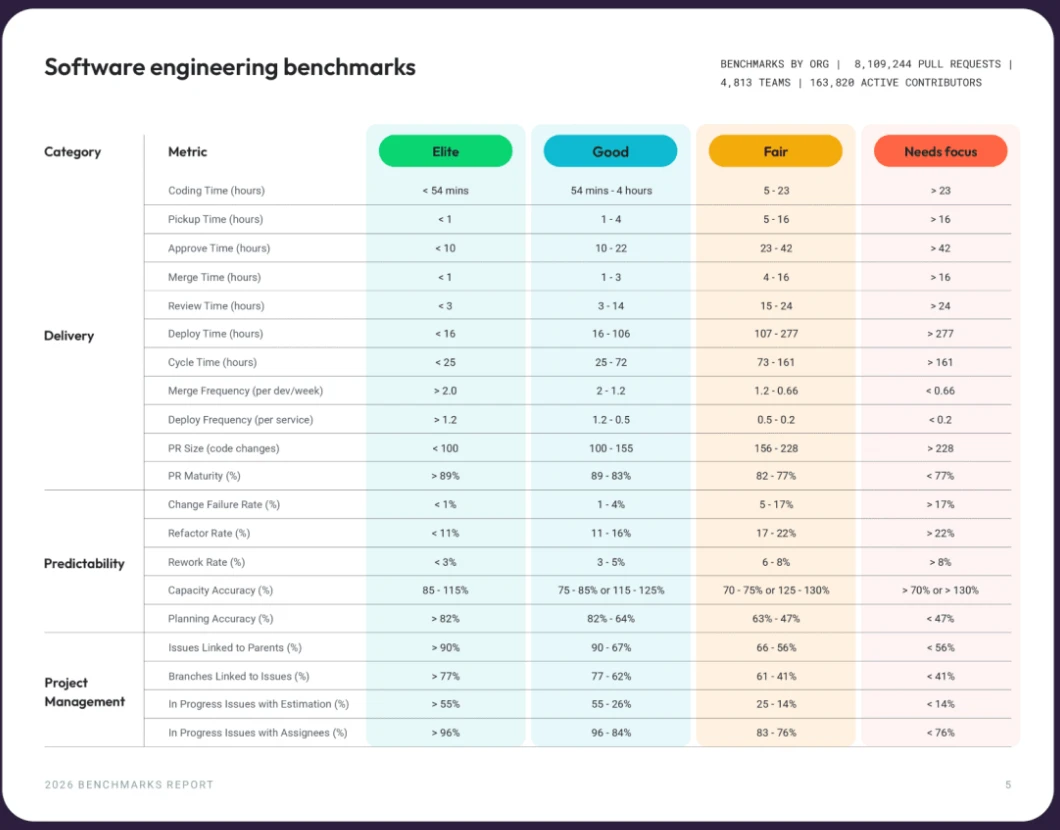
LinearB 가 PR 810만 건을 분석한 2026년 벤치마크에서 AI 가 만든 PR 은 첫 리뷰까지 4.6배 오래 기다렸고 승인률은 84.4% 대 32.7% 로 갈렸습니다. 병목의 크기와 AI 리뷰어·테스트 게이트·리스크 티어링이 그 병목을 어떻게 푸는지 정리했습니다.
AI 모델은 배포가 끝이 아니다
배포한 모델이 시간이 지나며 나빠지는 이유(Data Drift)와 그걸 재는 지표(Precision·Recall), 계속 돌리는 비용(TCO), 안에 뭐가 들었는지 아는 일(SBOM·SAST)까지 배포 이후의 운영을 정리했습니다.