LinearB 가 PR 810만 건을 분석한 2026년 벤치마크에서 AI 가 만든 PR 은 첫 리뷰까지 4.6배 오래 기다렸고 승인률은 84.4% 대 32.7% 로 갈렸습니다. 병목의 크기와 AI 리뷰어·테스트 게이트·리스크 티어링이 그 병목을 어떻게 푸는지 정리했습니다.
PR 이 쌓이는 화면
요즘 팀 저장소를 열면 열려 있는 PR 이 예전보다 두세 배 많습니다. 에이전트가 하루에 몇 개씩 올리기 때문입니다. 그런데 머지되는 속도는 그만큼 빨라지지 않았습니다. 왜일까요? 코드를 만드는 쪽은 자동화됐는데 읽고 판단하는 쪽은 여전히 사람이기 때문입니다. 에이전트 루프를 닫는 것은 검증인데 팀 단위에서 그 검증이 PR 리뷰이고 거기서 막힙니다.
LinearB 2026 벤치마크의 병목 수치
LinearB 의 2026년 소프트웨어 엔지니어링 벤치마크는 42개국 4,800개 팀의 PR 810만 건을 분석했습니다. AI 관련 지표만 뽑으면 이렇습니다.
- AI 가 만든 PR 은 첫 리뷰까지 4.6배 오래 기다린다. 에이전트가 직접 올린 PR 은 픽업까지 5.3배.
- 일단 리뷰가 시작되면 2배 빨리 끝난다.
- 승인률은 사람 PR 84.4%, AI PR 32.7%.
- 봇 PR 승인률은 도구마다 크게 다르다.
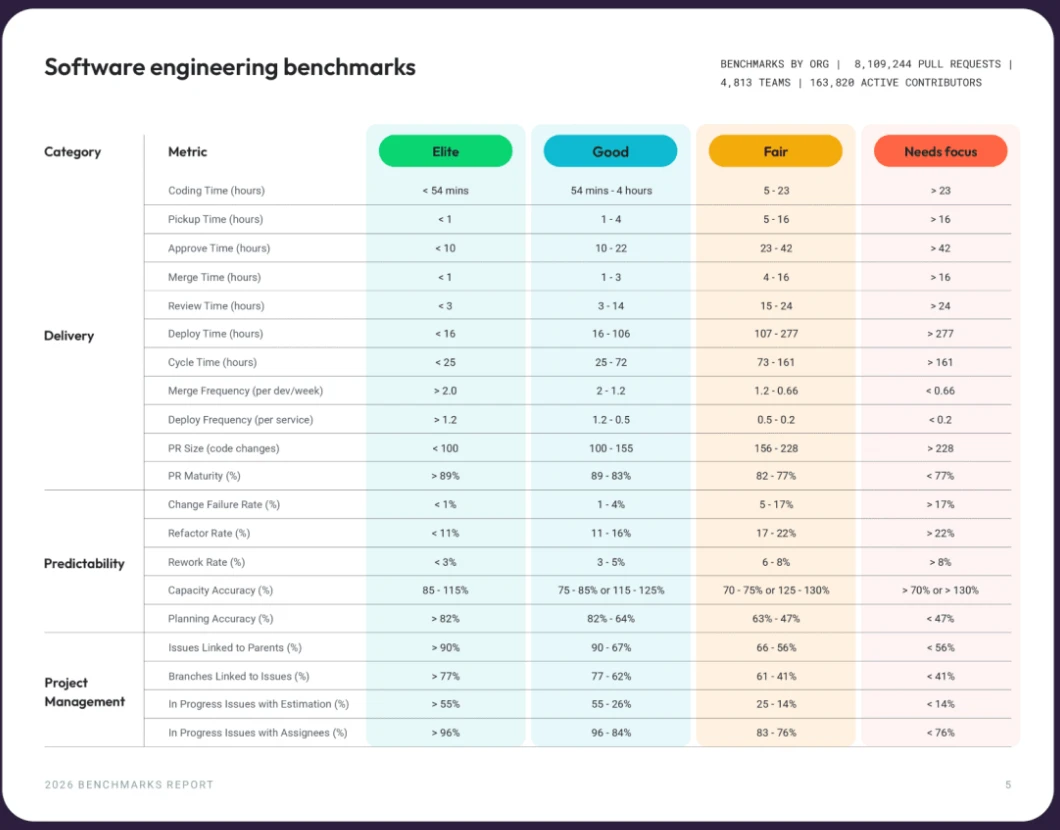
"오래 기다리는데 시작하면 빨리 끝난다"는 조합이 병목의 원인을 말해 줍니다. 리뷰어가 AI PR 을 뒤로 미룬다는 뜻입니다. 사람이 쓴 PR 은 작성자가 의도를 설명할 수 있지만 AI PR 은 그렇지 않아서 읽는 부담이 큽니다.
AI PR 의 이슈가 1.7배 많은 이유
읽는 부담이 실제로 크다는 근거도 있습니다. CodeRabbit 이 2025년 12월 17일에 낸 보고서는 오픈소스 PR 470건(AI 공동 작성 320건, 사람 150건)을 같은 분류 체계로 검토했습니다. AI 가 함께 쓴 PR 은 건당 이슈가 10.83개, 사람만 쓴 PR 은 6.45개였습니다. 약 1.7배입니다. 항목별로는 논리·정확성 문제가 75% 더 많았고 가독성 문제는 3배였습니다.
Anthropic 도 비슷한 관찰을 내부에서 했습니다. 2026년 7월 자료에 따르면 Anthropic 안에서 머지되는 코드의 약 80% 를 Claude 가 쓰는데, 자동 리뷰를 도입하기 전에는 실질적인 리뷰 코멘트를 받는 PR 이 16% 뿐이었습니다. 코드는 쏟아지는데 사람이 다 못 읽으니 대충 승인되는 PR 이 많았다는 겁니다.
첫 번째 대책, 리뷰어도 에이전트로
가장 직접적인 대책은 첫 리뷰를 에이전트에게 맡기는 겁니다. 2026년 들어 이 시장이 커졌습니다.
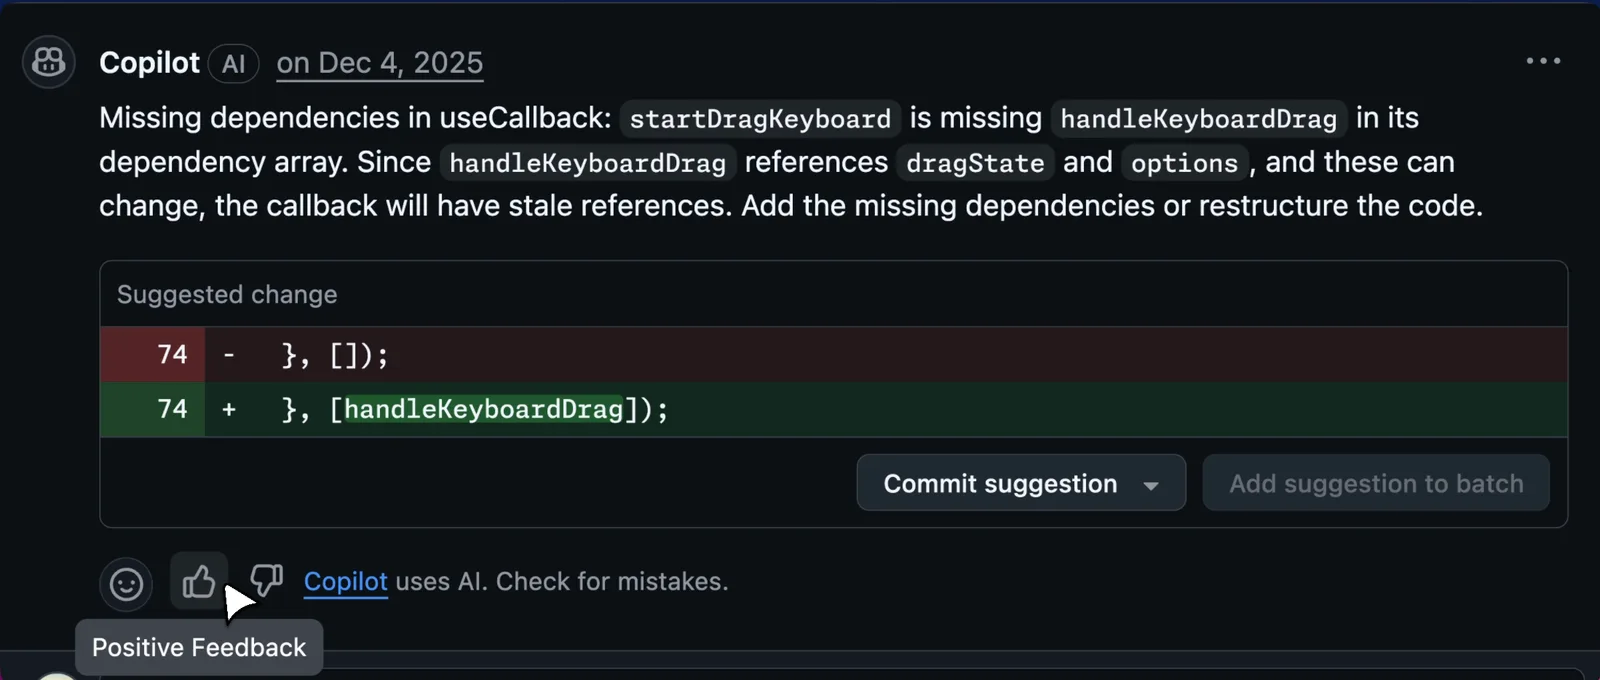
GitHub 은 2026년 3월 5일 Copilot 코드 리뷰가 2025년 4월 출시 이후 6,000만 건을 넘었고 GitHub 전체 리뷰의 5건 중 1건이 Copilot 리뷰라고 밝혔습니다. 리뷰의 71% 가 실행 가능한 피드백을 냈고 건당 평균 5.1개 코멘트였습니다. 3월의 아키텍처 변경 이후로는 도구 호출로 저장소를 직접 탐색해 관련 파일과 의존 관계를 읽고 코멘트를 씁니다.
Anthropic 은 2026년 3월 9일 Claude Code 용 Code Review 를 냈습니다. 구조가 서브에이전트 패턴 그대로입니다. PR 이 열리면 여러 에이전트가 병렬로 각자 다른 종류의 문제(논리 오류·보안·엣지 케이스·회귀)를 찾습니다. 검증 단계가 후보를 실제 코드 동작에 대조해 오탐을 거르고 중복을 합쳐 심각도순으로 인라인 코멘트를 답니다. 리뷰 한 건에 평균 20분, 비용은 15~25달러입니다. Anthropic 내부에서는 이 방식 도입 후 실질 리뷰 코멘트를 받는 PR 이 16% 에서 54% 로 올랐습니다.
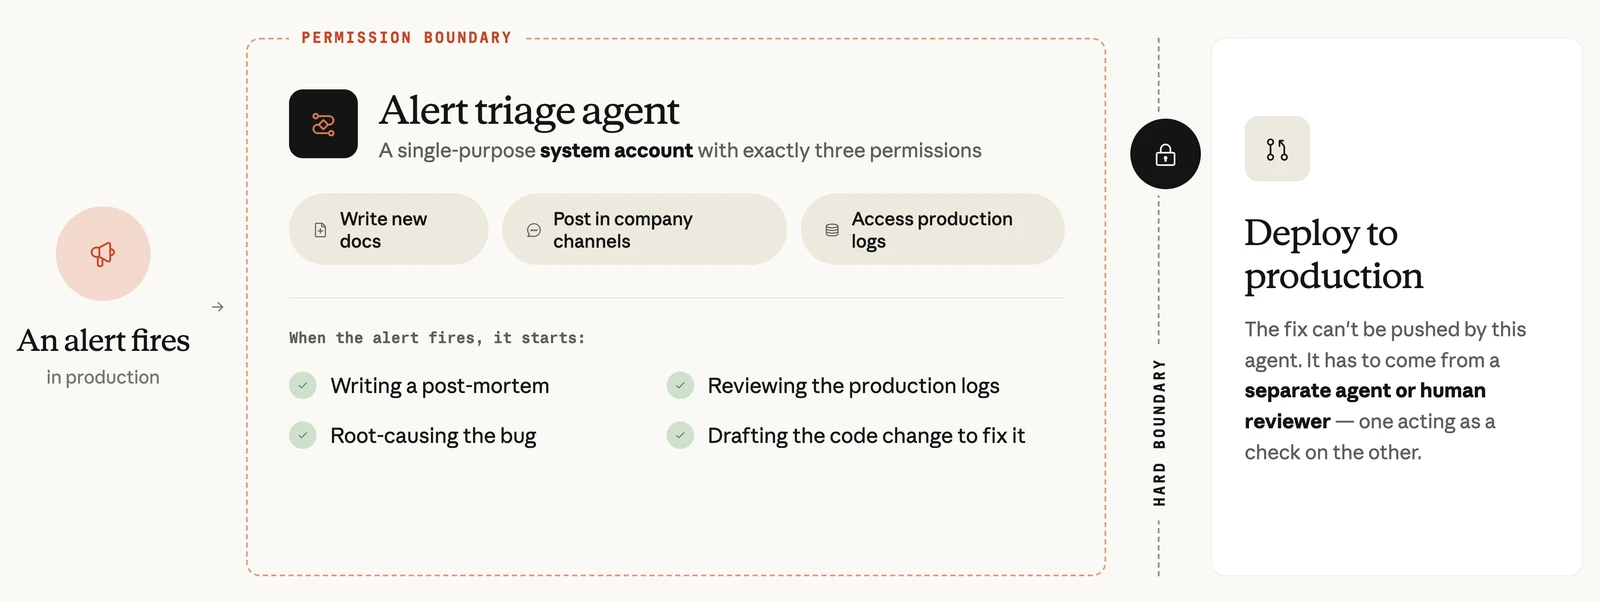
여기서 흥미로운 설계가 하나 있습니다. Code Review 는 PR 을 승인하거나 막지 않습니다. 결과를 check run 에 신호로 남길 뿐이고 머지를 막을지는 팀 CI 가 정합니다. 리뷰어 에이전트가 게이트가 되면 그 에이전트의 오탐이 곧 팀의 병목이 되기 때문입니다.
두 번째 대책, 리뷰 전에 기계가 거르기
에이전트 리뷰어도 결국 읽는 일입니다. 그보다 앞서 결정적으로 거를 수 있는 것은 기계에 맡깁니다. 검증을 얼마나 강하게 걸지가 여기서 다시 등장합니다.
- 테스트·타입 체크·린트를 Stop 훅에 걸어 통과 전에는 PR 을 못 올리게 한다.
- 아키텍처 경계는 커스텀 린터로 강제한다(OpenAI 하네스 엔지니어링 사례).
- 리뷰용 지침을
REVIEW.md같은 파일로 두고 "무엇을 Important 로 볼지, nit 는 몇 개까지, 어느 경로는 건너뛸지"를 명시한다.
Thoughtworks 는 Technology Radar 34권에서 이런 장치를 두 종류로 나눴습니다. 스펙과 스킬처럼 앞에서 방향을 잡는 통제와 테스트·뮤테이션 테스트처럼 뒤에서 결과를 확인하는 통제입니다. 뮤테이션 테스트가 눈에 띕니다. 코드에 일부러 결함을 심어 테스트가 잡는지 보는 기법인데, 에이전트가 테스트까지 같이 쓰는 시대에는 "테스트가 통과했다"가 "테스트가 의미 있다"를 보장하지 않아서입니다.
세 번째 대책, 리스크 티어링
Anthropic 의 SDLC 자료에서 가장 실용적으로 읽은 대목은 리스크 티어링입니다. 코드베이스를 위험도에 따라 나누고 중요한 코드에는 엄격한 사람 승인을, 나머지는 자동 승인에 맡기되 표본을 뽑아 사람이 확인합니다. 새 AI 리뷰어는 신뢰가 쌓일 때까지 사람 승인을 병행하는 그림자 모드로 돌립니다.
같은 자료에 인용된 Intercom 사례는 PR 의 19% 를 자동 승인했더니 배포 빈도는 두 배가 되고 다운타임은 35% 줄었다고 합니다. 모든 PR 을 사람이 같은 강도로 읽는 게 아니라 어디를 사람이 읽을지 고르는 것이 2026년식 리뷰입니다.
읽기에서 검증 설계로
병목의 원인은 명확합니다. 생성은 자동화됐고 검증은 사람에게 남았습니다. 대책도 방향이 하나입니다. 검증을 최대한 기계와 에이전트로 옮기고 사람은 위험한 곳과 표본만 봅니다. 그런데 에이전트에게 검증까지 맡기면 새 질문이 생깁니다. 그 에이전트가 조작당하면 어떻게 될까요? 다음 글에서는 프롬프트 인젝션과 권한 경계에 대해서 알아보겠습니다.
참고 자료
- 2026 Software Engineering Benchmarks Report — LinearB — 벤치마크 표 화면 캡처 출처
- State of AI vs Human Code Generation Report — CodeRabbit (2025-12-17)
- 60 million Copilot code reviews and counting — GitHub Blog (2026-03-05) — 리뷰 코멘트 화면 출처
- Code Review — Claude Code Docs
- How Anthropic secures its AI-native software development lifecycle — Anthropic (2026-07-21)
- Thoughtworks Technology Radar Vol.34 (2026-04-15)