표 데이터에는 XGBoost, 시계열에는 TimesFM, 추천에는 Two-Tower. 기업 AI 프로젝트의 상당수가 LLM 이 아닌 이 세 모델로 해결되는 이유와 각각의 원리를 정리했습니다.
요즘 AI 이야기를 듣다 보면 "AI = LLM" 처럼 느껴집니다. 저도 한동안 그랬습니다. 그런데 회사에서 실제로 들어오는 요청을 보면 이런 것들입니다. "이 고객이 이탈할까", "다음 달 매장별 수요가 얼마일까", "이 사용자에게 어떤 상품을 보여 줄까". 셋 다 입력이 문장이 아닙니다. 데이터 플랫폼에 쌓인 표와 숫자 열입니다. 이런 문제에 LLM 을 쓰면 비싸고 느리고 정확도도 떨어집니다. 그럼 뭘 써야 할까요? 표에는 XGBoost, 시계열에는 TimesFM, 추천에는 Two-Tower 입니다.
문제 종류가 모델을 정합니다
먼저 전체 지도를 그려 두겠습니다. 데이터 모양에 따라 쓰는 모델이 달라집니다.
| 데이터 | 문제 | 모델 |
|---|---|---|
| 문서·대화 | 읽기·쓰기·요약·질의응답 | LLM |
| 표(고객·거래·금융) | 분류·회귀 | XGBoost |
| 시계열(매출·트래픽·재고) | 미래 값 예측 | TimesFM |
| 사용자 × 상품 로그 | 추천 후보 검색 | Two-Tower |
표 데이터에는 XGBoost
첫 번째는 표입니다. Tabular Data 는 행이 사례, 열이 속성인 표입니다. 고객 한 명이 한 행, 나이·가입 기간·최근 구매액이 열입니다. 이 표로 "이탈 여부"(예/아니오)를 맞히면 분류(Classification), "다음 달 구매액"(숫자)을 맞히면 회귀(Regression)입니다.
이 문제의 기본값이 XGBoost 입니다. 2014년 Tianqi Chen 이 만든 오픈소스 라이브러리로, 방식은 Gradient Boosting 입니다. 작은 결정 트리를 하나 만듭니다. 그 트리가 틀린 만큼을 다음 트리가 보정하고 또 다음 트리가 남은 오차를 보정하는 식으로 트리를 수백 개 쌓습니다.
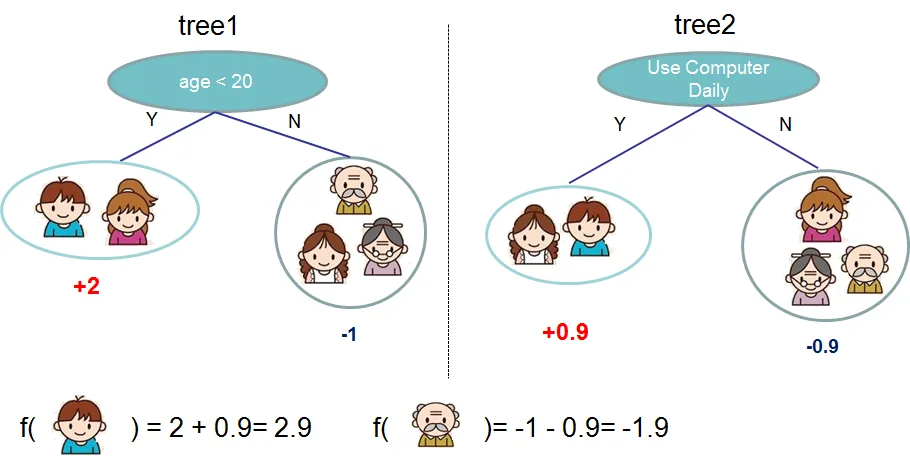
그림에서 한 사람의 점수는 tree1 의 +2 와 tree2 의 +0.9 를 더한 2.9 입니다. 트리 하나는 단순하지만 수백 개를 더하면 복잡한 경계를 그립니다.
기업에서 여전히 XGBoost 를 쓰는 이유는 세 가지입니다. 표 데이터에서는 대체로 딥러닝보다 정확합니다(2022년 Grinsztajn 등의 비교 연구가 이걸 체계적으로 보였습니다). CPU 한 대로 분 단위에 학습이 끝납니다. 그리고 어느 열이 결정에 얼마나 기여했는지 설명할 수 있습니다. 금융·보험처럼 설명 의무가 있는 곳에서 마지막 이유가 큽니다.
시계열에는 TimesFM
두 번째는 시간 순서가 있는 숫자입니다. 시계열은 시간 순으로 찍힌 숫자 열입니다. 일별 매출, 시간별 트래픽, 주별 재고. 여기서 미래 값을 맞히는 것이 Forecasting 입니다. 전통적으로는 ARIMA 같은 통계 모델이나 시계열마다 따로 학습한 딥러닝 모델을 썼습니다. 매장 1,000개면 모델 1,000개를 관리하는 식입니다.
Google Research 가 2024년 2월 공개한 TimesFM 은 여기에 LLM 의 사전학습 개념을 가져왔습니다. 시계열 1,000억 개 시점으로 미리 학습한 2억 파라미터 모델입니다. 처음 보는 시계열도 추가 학습 없이 예측합니다(zero-shot). 구조는 LLM 과 같은 Transformer 디코더입니다. 토큰 대신 시계열 조각(patch)을 넣고 다음 조각을 예측합니다.
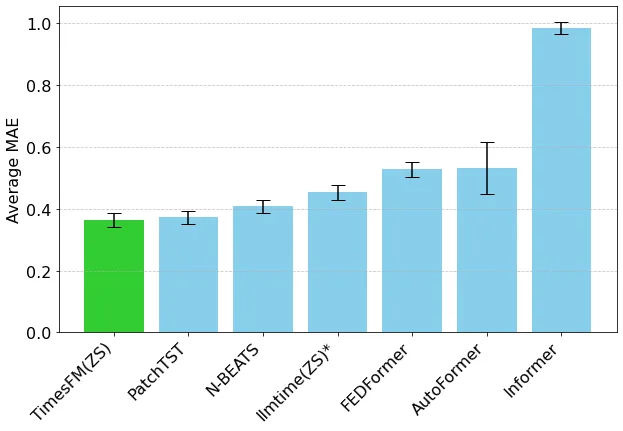
그림은 ETT 데이터셋에서 TimesFM 의 zero-shot 오차(MAE)가 그 데이터로 직접 학습한 DeepAR·PatchTST 와 비슷한 수준임을 보여 줍니다. 모델은 Hugging Face(google/timesfm)에 공개돼 있어 폐쇄망에도 반입할 수 있습니다. 2억 파라미터면 BF16 으로 400MB, GPU 없이도 돌아가는 크기입니다.
추천에는 Two-Tower
세 번째는 추천입니다. 추천은 "사용자 한 명에게 상품 수백만 개 중 무엇을 보여 줄까"입니다. 수백만 개를 전부 정밀하게 점수 매길 수는 없으니 두 단계로 나눕니다. 후보 수백 개를 빠르게 추리는 Retrieval 과 그 수백 개에 정밀 점수를 매기는 Ranking 입니다.
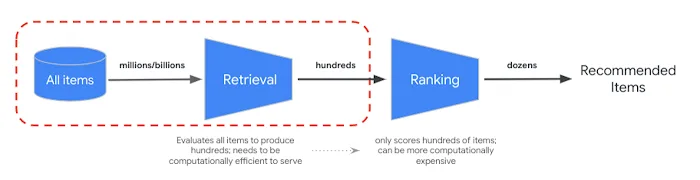
Retrieval 단계의 표준이 Two-Tower 입니다. 사용자 정보를 벡터로 바꾸는 신경망(User tower)과 상품 정보를 벡터로 바꾸는 신경망(Item tower)을 따로 둡니다. 두 벡터의 내적이 클수록 "이 사용자가 이 상품을 좋아한다"가 되게 학습합니다.
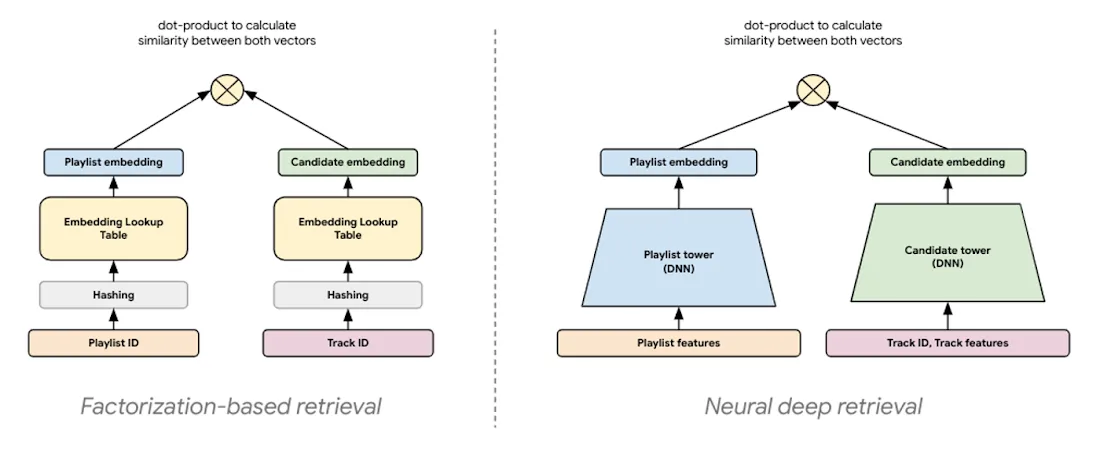
두 탑을 분리한 이유가 핵심입니다. 상품 벡터는 사용자와 무관하니 미리 전부 계산해 벡터 DB 에 넣어 둘 수 있습니다. 요청이 오면 사용자 벡터 하나만 계산해 가까운 상품 벡터를 찾습니다. RAG 와 정확히 같은 구조입니다. 문서 대신 상품, 질문 대신 사용자일 뿐입니다. 벡터 DB 한 번 세워 두면 RAG 와 추천이 같은 인프라를 씁니다.
그럼 이 셋은 인프라 어디에 둘까요
이 세 모델은 LLM 인프라에서 아주 작은 부분만 씁니다. XGBoost 는 CPU 에서, TimesFM 은 GPU 한 장이면 충분합니다. Two-Tower 는 벡터 DB 가 핵심입니다. 학습 데이터는 Lakehouse 의 Iceberg 테이블에서 Spark 로 뽑고 결과는 다시 테이블로 씁니다.
그래서 기업 AI 플랫폼은 LLM 용 GPU 클러스터 하나로 끝나지 않습니다. 표·시계열·추천 모델이 같은 데이터 플랫폼 위에서 함께 돕니다. 어느 문제에 어느 모델을 붙일지 고르는 일이 인프라 팀과 데이터 팀의 공동 업무가 됩니다. 그런데 모델이 열 개가 되면 "지금 잘 돌고 있나"를 어떻게 알 수 있을까요? 다음 글에서 배포 이후의 운영에 대해서 알아보겠습니다.
참고 자료
- 그림: Introduction to Boosted Trees — XGBoost Docs (Apache-2.0)
- Why do tree-based models still outperform deep learning on tabular data? — Grinsztajn et al., 2022
- 그림: A decoder-only foundation model for time-series forecasting — Google Research Blog, 2024-02-02
- 그림: Scaling deep retrieval with TensorFlow Recommenders and Vertex AI Matching Engine — Google Cloud Blog