챗봇 답변의 첫 글자만 늦는 이유는 답을 만드는 과정이 Prefill 과 Decode 두 단계로 나뉘고 병목이 서로 다르기 때문입니다. 둘 사이의 KV Cache 가 왜 필요하고 얼마나 큰지, TTFT·Tokens/sec 가 뭘 재는지 정리했습니다.
챗봇에 긴 문서를 붙여 넣고 질문해 보신 적 있으실 겁니다. 첫 글자가 나오기까지 한참 걸리다가 일단 나오기 시작하면 줄줄 흘러나옵니다. 저는 이게 그냥 네트워크 지연인 줄 알았는데 아니었습니다. 왜 그럴까요? 모델이 답을 만드는 과정이 두 단계로 나뉘어 있고 두 단계의 병목이 다르기 때문입니다. 첫 글자 전이 Prefill, 그 뒤가 Decode 입니다. LLM 이 하는 일이 "다음 토큰 하나 고르기"라는 데서 시작하면 이 두 단계가 왜 생기는지 알게 됩니다.
답이 한 번에 안 나오는 이유
LLM 은 다음 토큰 하나를 고르는 기계입니다. 문장을 만들려면 고른 토큰을 입력 끝에 붙이고 다시 다음 토큰을 고르는 일을 반복해야 합니다. 이 방식을 자기회귀 생성(autoregressive generation)이라고 부릅니다. 답변이 300 토큰이면 모델을 300번 통과합니다.
이때 모델이 매번 보는 입력 전체 — 시스템 프롬프트, 대화 이력, 붙여 넣은 문서, 지금까지 생성한 답 — 를 컨텍스트라고 합니다. 모델마다 컨텍스트 상한이 있습니다. Qwen2.5-7B 의 max_position_embeddings 는 131,072 토큰입니다.
프롬프트 전체를 한 번에 읽는 Prefill
사용자가 보낸 프롬프트는 토큰 수천 개일 수 있습니다. 그런데 이 토큰들은 이미 다 알고 있으니 한 토큰씩 처리할 필요가 없습니다. Attention 계산을 모든 토큰에 대해 한 번에 행렬 곱으로 처리합니다. 이 단계가 Prefill 입니다.
행렬과 행렬을 곱하는 일은 GPU 가 가장 잘하는 일이라 이 단계는 GPU 연산 능력을 거의 다 씁니다. 그래서 Prefill 은 compute-bound, 즉 계산 속도가 병목입니다. 프롬프트가 길수록 이 단계가 길어지고 그만큼 첫 토큰이 늦게 나옵니다. 첫 글자가 늦는 이유가 이것입니다.
계산한 Key·Value 를 저장해 둡니다 (KV Cache)
Prefill 이 끝나면 첫 토큰이 나옵니다. 그럼 두 번째 토큰은 어떻게 만들까요? 방금 나온 토큰을 붙여 다시 Attention 을 하려면 앞선 토큰들의 Key 와 Value 가 전부 필요한데, 이건 Prefill 때 이미 계산한 값입니다. 다시 계산하면 낭비입니다.
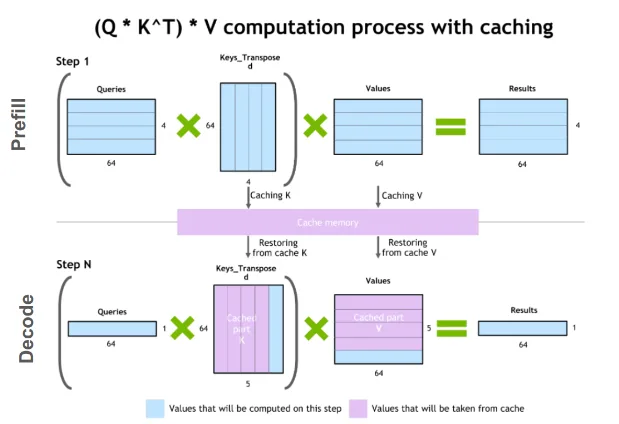
그래서 각 층에서 계산한 Key·Value 를 GPU 메모리에 그대로 둡니다. 이것이 KV Cache 입니다. 새 토큰이 들어오면 그 토큰의 K·V 만 계산해 캐시 끝에 붙이고 Attention 은 캐시 전체를 읽어서 계산합니다.
그런데 왜 Query 는 캐시하지 않을까요? Attention 에서 Query 는 "지금 토큰이 무엇을 볼지"를 정하는 값이라 지금 토큰의 것만 씁니다. 앞 토큰들의 Query 는 그 토큰 차례에 이미 쓰고 끝났습니다. 반면 Key·Value 는 뒤에 오는 모든 토큰이 계속 참조하니 저장할 가치가 있습니다.
한 토큰씩 메모리를 읽으며 만드는 Decode
첫 토큰 이후는 한 번에 토큰 하나씩 만듭니다. 이 단계가 Decode 입니다. 입력이 토큰 하나뿐이니 계산은 행렬 × 벡터 수준으로 작습니다. 그런데 그 작은 계산을 위해 매번 76억 개 가중치 전부와 KV Cache 전체를 GPU 메모리에서 읽어 와야 합니다.
GPU 는 계산은 빠른데 메모리에서 데이터를 가져오는 속도는 그보다 훨씬 느립니다. Decode 단계는 계산량에 비해 읽어야 할 데이터가 너무 많아서 memory-bandwidth-bound, 즉 메모리 대역폭이 병목입니다. NVIDIA 문서도 이 단계의 지연은 가중치·K·V 를 메모리에서 옮기는 속도가 결정한다고 적고 있습니다. 양자화가 메모리뿐 아니라 속도에도 도움이 되는 이유가 이것입니다. 읽을 바이트가 줄기 때문입니다.
긴 컨텍스트가 VRAM 을 잡아먹는 계산
그럼 KV Cache 는 얼마나 클까요? 토큰마다 쌓이니 토큰 하나당 크기부터 보면 됩니다.
토큰당 KV Cache = 2(K, V) × 층 수 × (KV 헤드 수 × 헤드 차원) × 바이트 수NVIDIA 문서의 예시인 Llama 2 7B(32층, hidden 4096, FP16)로 계산하면 토큰당 2 × 32 × 4096 × 2 = 512KB 입니다. 컨텍스트 4,096 토큰이면 약 2GB 입니다. 요청 하나가 그렇고 동시 요청 열 개면 20GB 입니다. 가중치 14GB 와 별개로 말입니다.
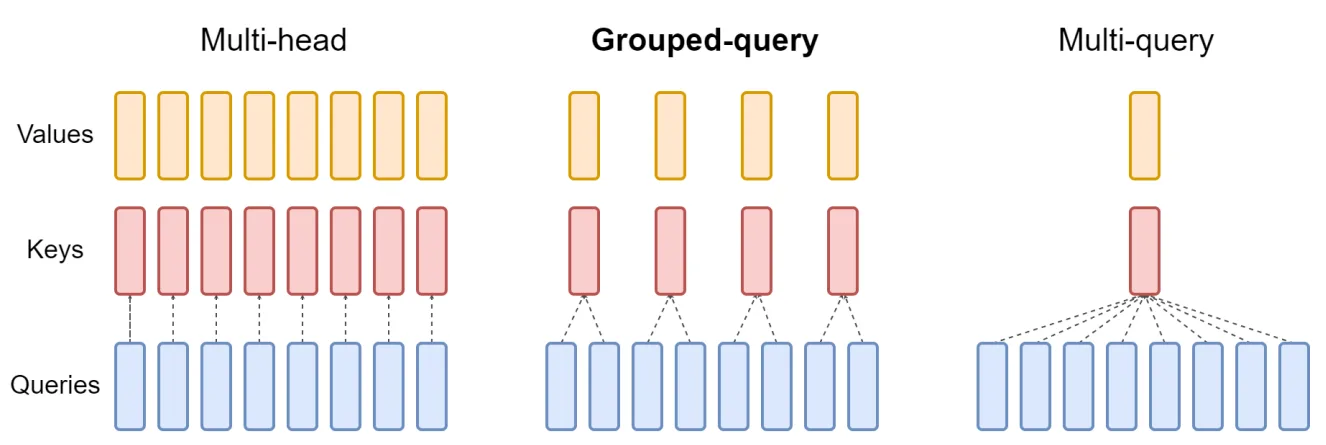
Qwen2.5-7B 는 Key·Value 헤드를 4개만 두고 Query 헤드 28개가 나눠 쓰는 GQA 구조인데 그 효과가 여기서 납니다. KV 헤드가 4개뿐이라 토큰당 2 × 28 × (4 × 128) × 2 = 56KB, Llama 2 7B 의 1/9 수준입니다. 그래도 128K 컨텍스트를 다 채우면 요청 하나에 약 7GB 가 필요합니다.
지표로 옮긴 TTFT·TPOT·Tokens/sec
이 두 단계를 사용자 체감 지표로 옮기면 세 가지가 나옵니다.
| 뜻 | 어느 단계가 결정 | |
|---|---|---|
| TTFT | Time To First Token — 첫 토큰까지 걸린 시간 | Prefill (프롬프트 길이) |
| TPOT | Time Per Output Token — 토큰 하나 만드는 시간 | Decode (메모리 대역폭) |
| Tokens/sec | 초당 생성 토큰 수 = 1 / TPOT | Decode |
긴 문서를 붙여 넣었을 때 첫 글자가 늦는 건 TTFT 가 커진 것이고 그 뒤로 글자가 흘러나오는 속도는 TPOT 입니다. 두 지표는 병목이 다르니 따로 최적화합니다. llm-d 같은 분산 서빙 프레임워크가 Prefill 과 Decode 를 아예 다른 GPU 에서 돌리는 이유가 이것입니다.
여기까지 정리하면
프롬프트는 Prefill 로 한 번에 처리해 KV Cache 를 만들고 답은 Decode 로 한 토큰씩 만들며 캐시를 늘려 갑니다. Prefill 은 계산이, Decode 는 메모리 읽기가 병목입니다. 그 메모리에 가중치와 KV Cache 가 함께 올라가야 하는데 그럼 GPU 메모리는 얼마나 필요할까요? 다음 글에서는 GPU 메모리 자체와 그 메모리를 줄이는 양자화에 대해서 알아보겠습니다.