model.generate() 로 잘 돌던 모델이 동시 요청 앞에서 막히는 이유와, vLLM 이 PagedAttention·Continuous Batching 으로 그 문제를 어떻게 푸는지 코드와 함께 정리했습니다.
실험 노트북에서 model.generate() 로 답을 잘 받아 보셨을 겁니다. 저도 처음엔 "이걸 FastAPI 로 감싸면 서비스 아닌가?" 싶었습니다. 그런데 사용자 100명이 동시에 물으면 이 코드는 바로 막힙니다. 왜 막힐까요? generate 는 요청 하나가 끝날 때까지 GPU 를 붙들고 있고 KV Cache 를 요청마다 최대 길이로 미리 잡아 메모리를 낭비하기 때문입니다. 이 두 문제를 전담하는 소프트웨어가 추론 엔진이고 그 대표가 vLLM 입니다. 먼저 PyTorch 로 직접 올리는 것부터 해 보겠습니다.
먼저 PyTorch 로 직접 올려 봅니다
모델은 Hugging Face 저장소에서 받습니다. Hugging Face Hub 는 모델 파일을 git 저장소처럼 관리하는 곳이고 transformers 라이브러리가 이름만 주면 파일을 받아 메모리에 올려 줍니다. 그 아래에서 실제 행렬 계산을 하는 프레임워크가 PyTorch 입니다. 학계·업계 대부분의 LLM 이 PyTorch 로 만들어지고 배포됩니다.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype="auto", device_map="cuda")

inputs = tokenizer("LLM 추론 서버가 왜 필요한가요?", return_tensors="pt").to("cuda")
out = model.generate(**inputs, max_new_tokens=200)
print(tokenizer.decode(out[0], skip_special_tokens=True))
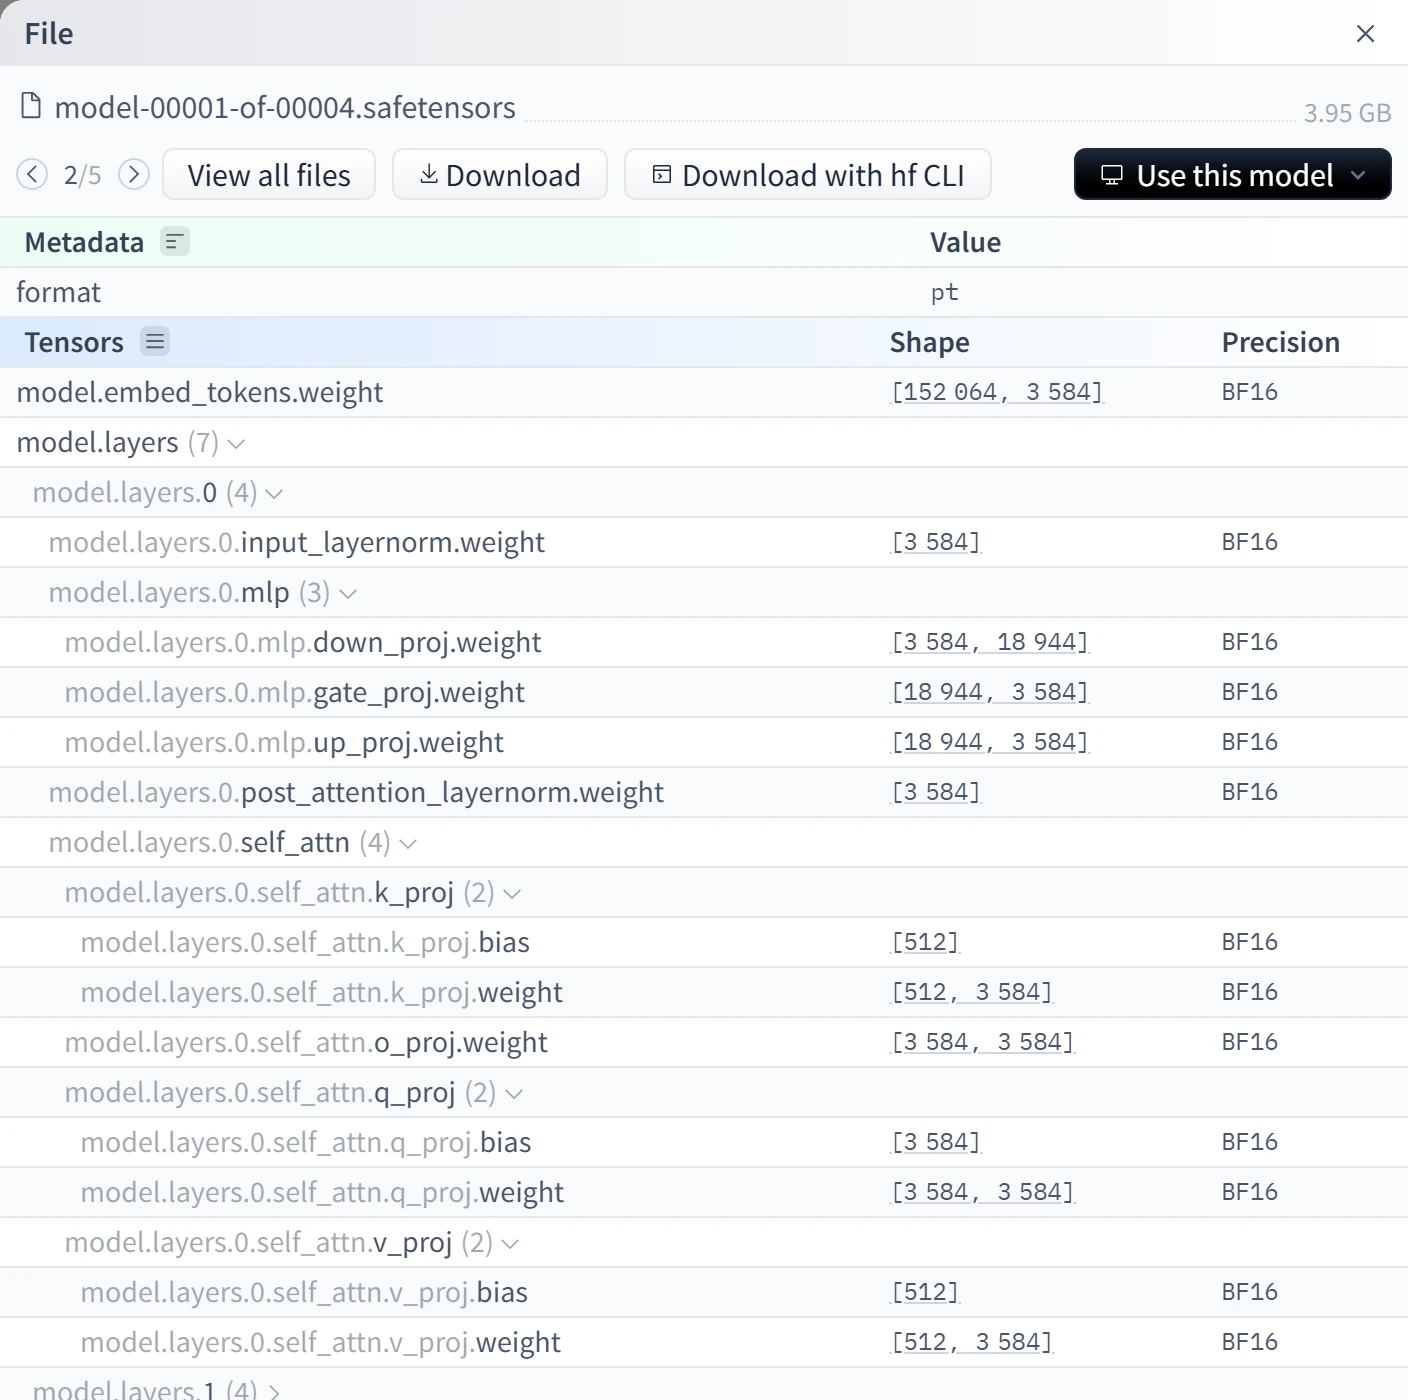
from_pretrained 가 저장소의 safetensors 파일을 읽어 GPU(cuda)로 올립니다. torch_dtype="auto" 는 파일에 적힌 BF16 그대로 쓰라는 뜻입니다. generate 는 프롬프트를 한 번에 처리(Prefill)한 뒤 토큰을 하나씩 만드는(Decode) 반복을 안에서 돌려 토큰을 이어 붙입니다. 실험·연구·데모라면 이걸로 충분합니다.
그런데 왜 서비스는 안 될까요
첫 번째 문제는 동시 요청입니다. generate 는 호출 하나가 끝날 때까지 GPU 를 붙들고 있습니다. 요청 100개가 오면 99개는 줄을 섭니다. 여러 요청을 묶어(배치) 한 번에 처리하면 나아지는데 그러면 두 번째 문제가 나옵니다.
배치 안의 요청들은 답 길이가 제각각입니다. 어떤 요청은 10 토큰에 끝나고 어떤 요청은 500 토큰을 씁니다. 단순한 배치는 가장 긴 요청이 끝날 때까지 배치 전체가 기다립니다. 먼저 끝난 요청의 슬롯은 그동안 빈 채로 GPU 를 차지합니다.
세 번째는 KV Cache 입니다. 앞 토큰들의 Key·Value 를 저장해 두는 GPU 메모리 영역인데 요청마다 캐시가 얼마나 길어질지 모르니 종래 시스템은 최대 길이만큼 미리 잡아 둡니다. vLLM 팀은 이 방식이 메모리의 60~80% 를 낭비한다고 측정했습니다.
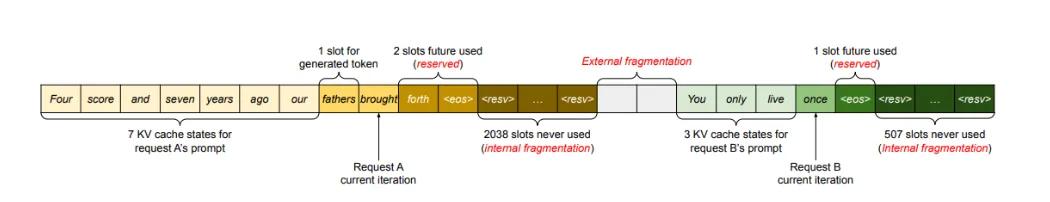
이 문제를 전담하는 소프트웨어 — 추론 엔진
이 세 문제를 전담하는 소프트웨어가 추론 엔진(Inference Engine)입니다. 모델 파일은 같은데 그걸 실행하는 방식이 다릅니다. 요청을 받아 줄 세우고 배치를 짜고 KV Cache 를 관리해서 결과를 HTTP 로 돌려줍니다. 학습에는 관여하지 않습니다.
둘을 비교해 보면 아래와 같습니다.
| 연구·실험 | 서비스 | |
|---|---|---|
| 진입점 | Python 스크립트 | HTTP API |
| 실행 | PyTorch generate | 추론 엔진(vLLM 등) |
| 동시 요청 | 순차 처리 | Continuous Batching |
| KV Cache | 요청마다 최대 길이 예약 | 블록 단위 동적 할당 |
| 모델 | 같은 safetensors | 같은 safetensors |
vLLM 이 KV Cache 를 다루는 방식 — PagedAttention
vLLM 은 UC Berkeley 의 Woosuk Kwon·Zhuohan Li 등이 만들어 2023년 6월 20일 공개한 오픈소스 추론 엔진입니다. 핵심 아이디어는 PagedAttention 입니다. 운영체제가 메모리를 페이지 단위로 나눠 관리하듯이, KV Cache 를 고정 크기 블록으로 나눠 필요할 때 하나씩 할당합니다. 블록은 메모리에서 이어져 있을 필요가 없고 블록 테이블이 위치를 기억합니다.
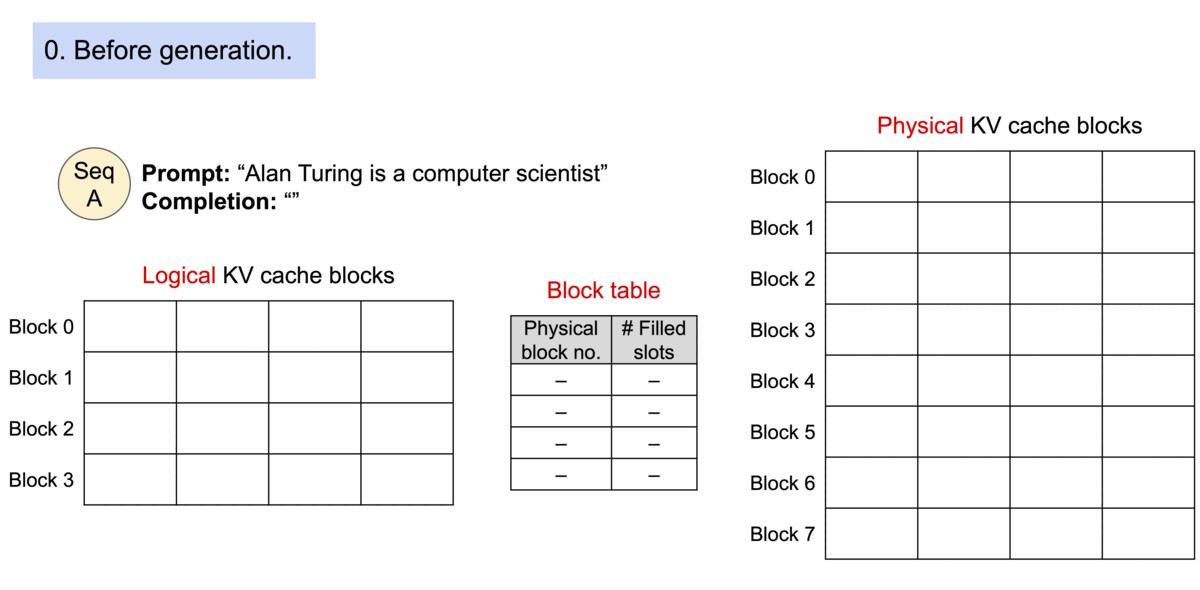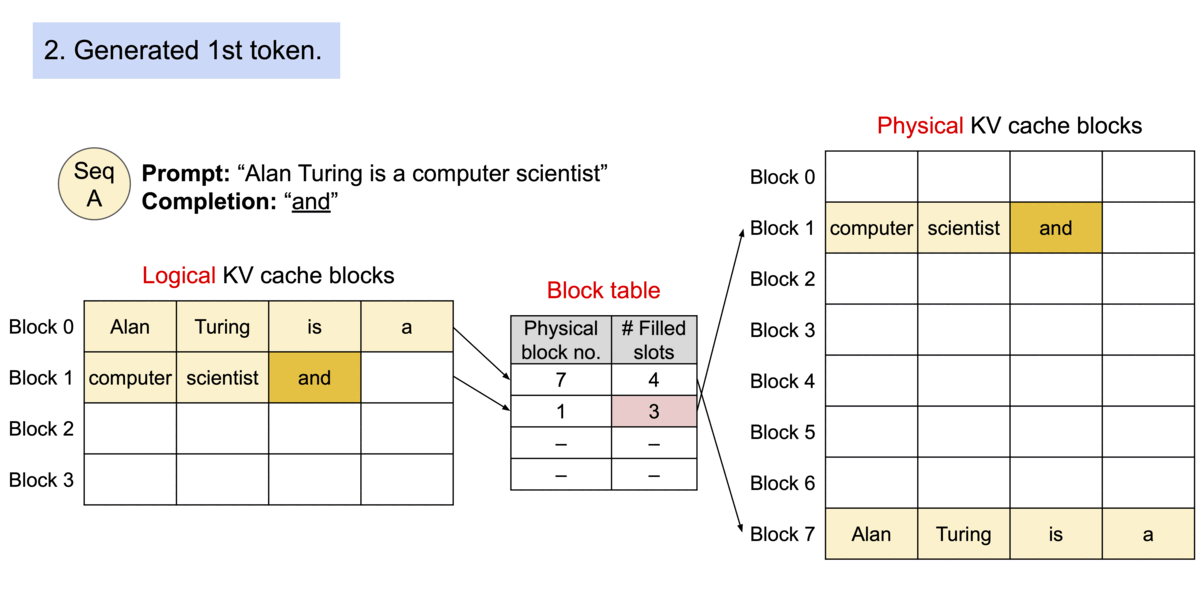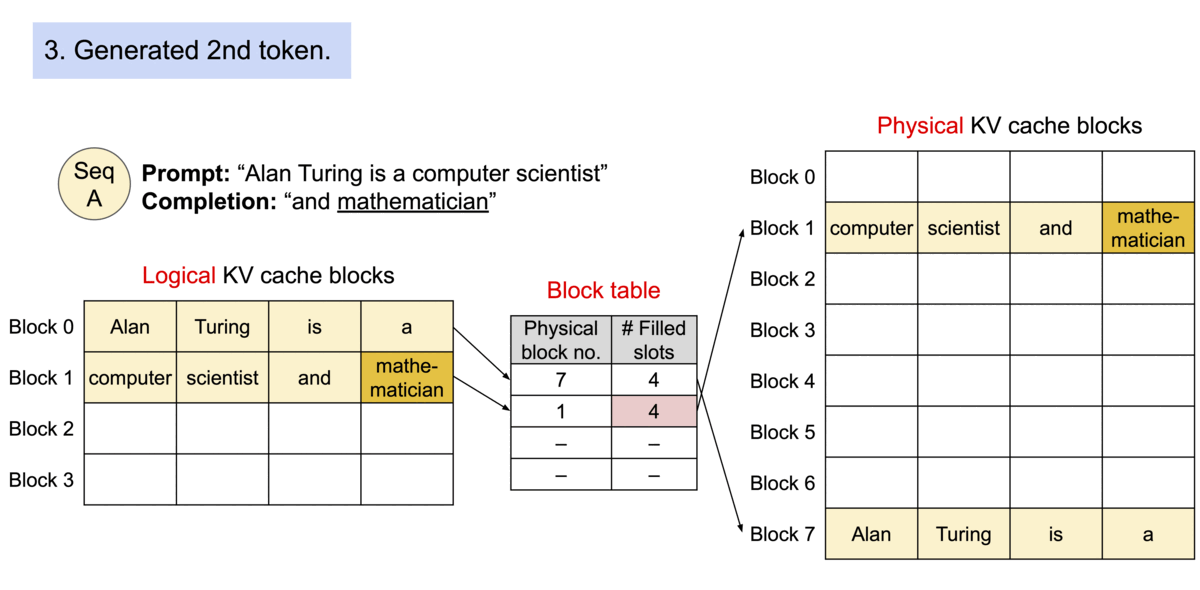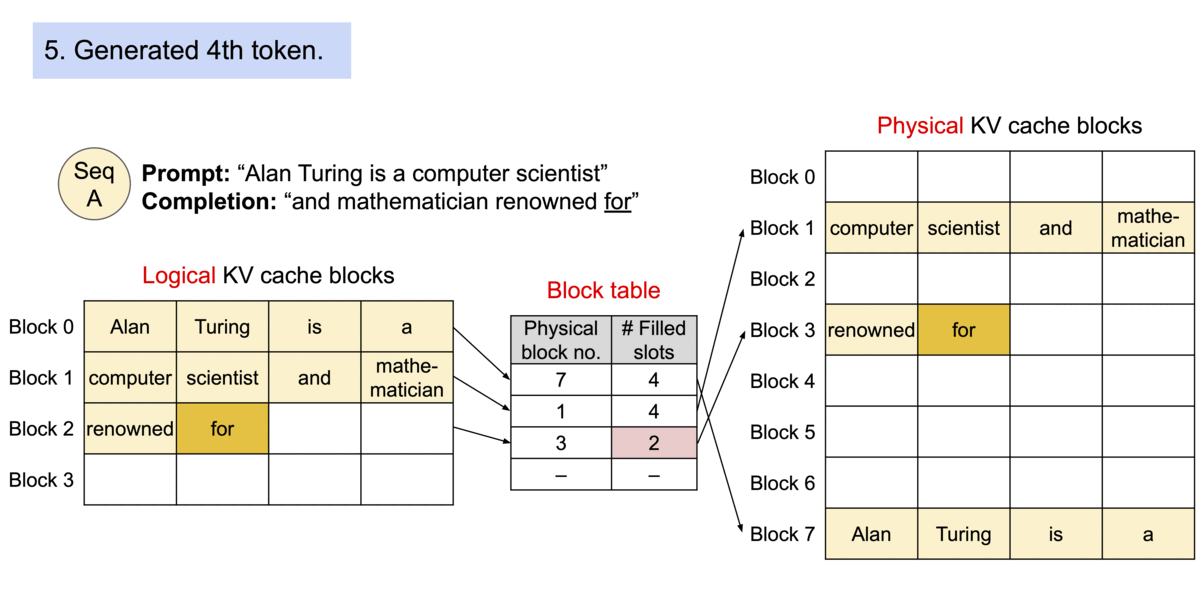
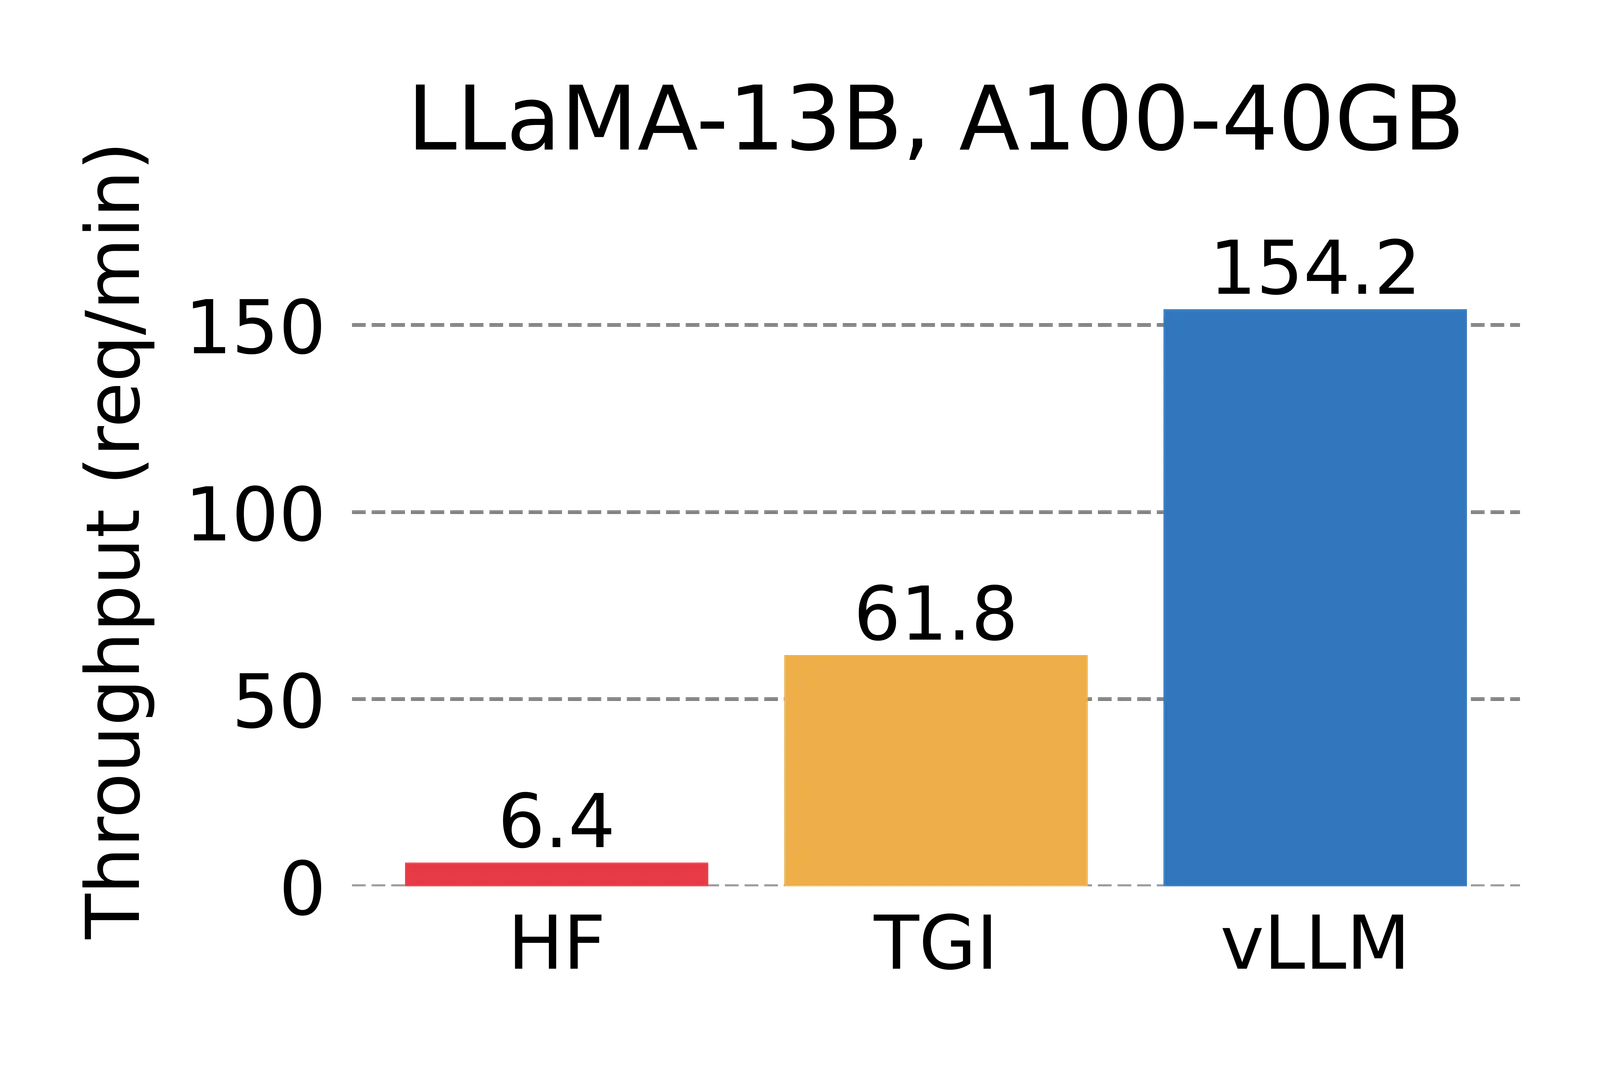
이렇게 하면 최대 길이를 미리 예약할 필요가 없어서 낭비가 4% 미만으로 줄고 그만큼 더 많은 요청을 동시에 실을 수 있습니다. vLLM 팀은 같은 GPU 에서 Hugging Face Transformers 대비 최대 24배, 당시 Hugging Face 의 서빙 도구 TGI 대비 최대 3.5배 처리량을 냈다고 발표했습니다.
슬롯이 나면 바로 다음 요청 — Continuous Batching
두 번째 문제(긴 요청을 기다리는 배치)는 Continuous Batching 이 풉니다. 배치를 요청 단위가 아니라 토큰 생성 한 스텝 단위로 다시 짭니다. 어떤 요청이 끝나면 그 스텝에서 바로 빼고 대기 중인 요청을 그 슬롯에 넣습니다. GPU 는 빈 슬롯 없이 계속 돌고 새 요청은 앞 요청이 끝나길 기다리지 않습니다.
그런데 이게 PagedAttention 없이는 제대로 안 됩니다. 새 요청을 끼워 넣으려면 그 요청의 KV Cache 공간이 있어야 하는데 최대 길이 예약 방식에서는 공간이 잘 나지 않기 때문입니다. 두 기법은 한 묶음입니다.
명령 한 줄로 OpenAI 호환 API 띄우기
vLLM 은 이 모든 것을 명령 한 줄 뒤에 숨깁니다.
pip install vllm
vllm serve Qwen/Qwen2.5-7B-Instruct
서버가 뜨면 http://localhost:8000/v1 에서 OpenAI 와 같은 형식의 API 를 받습니다. 이미 OpenAI SDK 로 짜 둔 애플리케이션이라면 base_url 만 바꾸면 그대로 동작합니다.
from openai import OpenAI

client = OpenAI(api_key="EMPTY", base_url="http://localhost:8000/v1")
res = client.chat.completions.create(
    model="Qwen/Qwen2.5-7B-Instruct",
    messages=[{"role": "user", "content": "LLM 추론 서버가 왜 필요한가요?"}],
)
print(res.choices[0].message.content)
이 호환성이 업계 표준이 됐습니다. 애플리케이션 쪽은 어느 엔진이 뒤에 있든 같은 코드를 쓰고 인프라 쪽은 엔진을 바꿔도 앱을 안 고쳐도 됩니다.
vLLM 말고는 없을까요
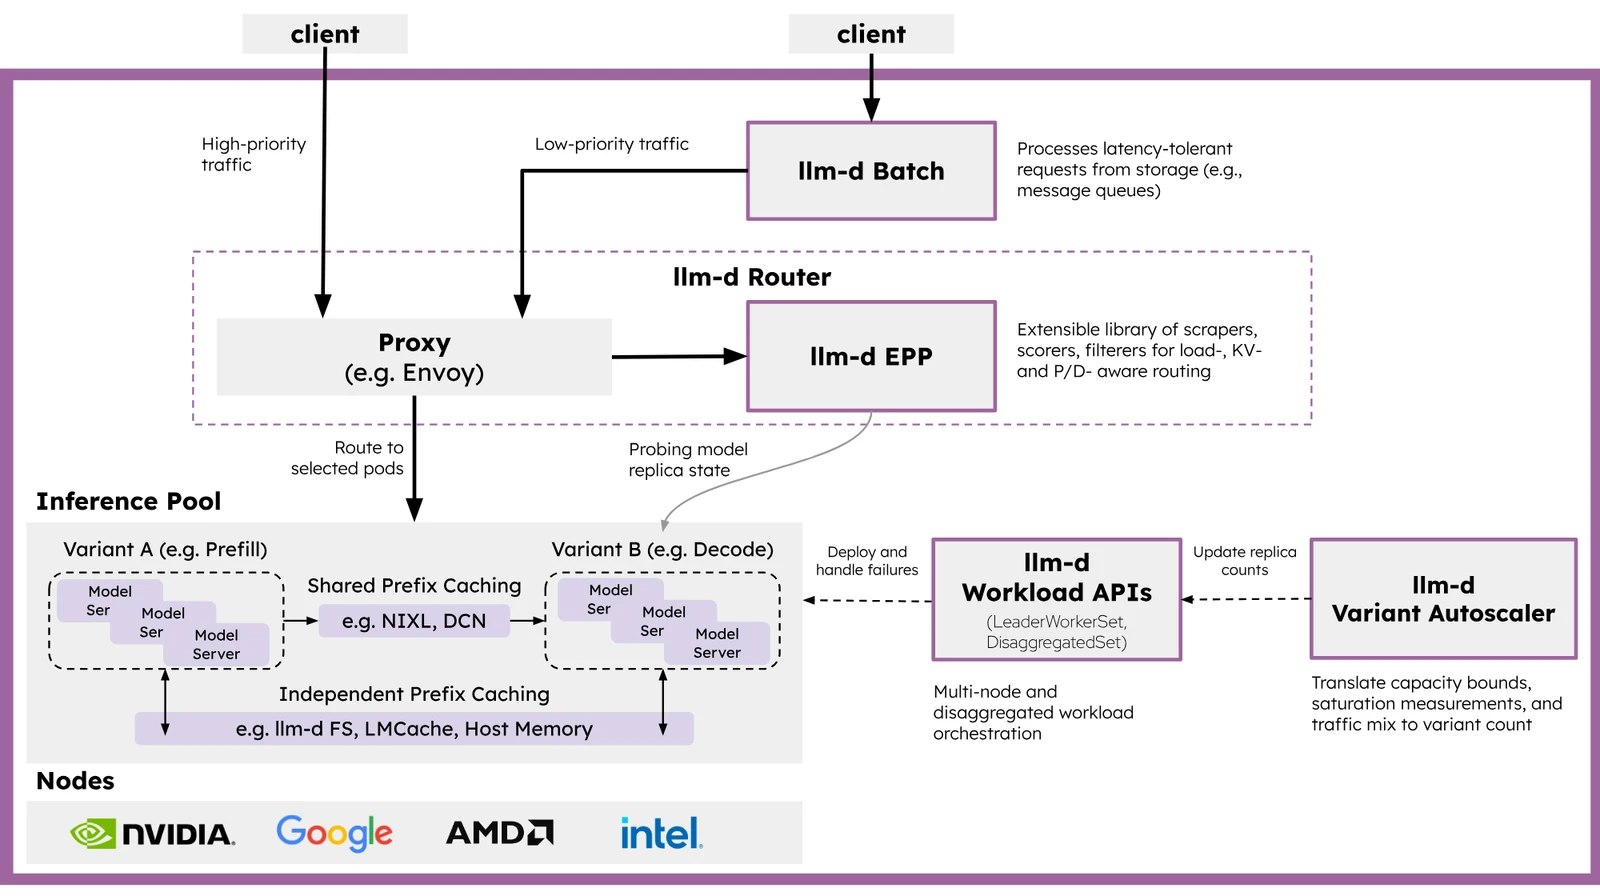
같은 역할을 하는 엔진이 몇 개 더 있습니다. NVIDIA 의 TensorRT-LLM 은 NVIDIA GPU 에 맞춰 커널을 컴파일해 최고 속도를 내는 대신 설정이 무겁습니다. SGLang 은 vLLM 과 비슷한 구조에 프롬프트 접두어 캐시를 강조합니다. 노트북에서 GGUF 파일을 돌리는 llama.cpp·Ollama 도 넓게 보면 추론 엔진입니다. 데이터센터 기준 기본 선택지는 vLLM 이고 분산 서빙 프레임워크인 llm-d 도 vLLM 을 실행 단위로 씁니다.
여기까지가 GPU 서버 한 대 안의 이야기입니다. 그럼 GPU 가 여러 장, 서버가 여러 대가 되면 어떻게 될까요? 다음 글에서 vLLM 위에 얹는 층인 Kubernetes·MIG·llm-d 에 대해서 알아보겠습니다.