인터넷이 끊긴 폐쇄망에서도 생성형 AI 는 됩니다. LLM·임베딩 모델·벡터 DB·컨테이너 이미지·패키지를 어떻게 반입하고 들어온 뒤에는 무엇을 관리해야 하는지 정리했습니다.
금융·공공·방산 쪽에서 일하시는 분들은 "우리는 인터넷이 안 되는데 ChatGPT 같은 걸 쓸 수 있나요?"라는 질문을 자주 받으실 겁니다. 저도 처음엔 API 를 못 쓰니 불가능하다고 생각했습니다. 결론부터 말하면 됩니다. 모델은 파일이고 파일을 GPU 에 올려 서버로 띄우면 되고 문서는 벡터 DB 에서 찾아 붙이면 됩니다. 전부 회사 안에서 할 수 있는 일입니다. 문제는 그 부품들을 어떻게 안으로 들여오느냐입니다.
먼저 용어 — Air Gap · 폐쇄망 · On-premise
On-premise 는 클라우드가 아니라 회사 자체 서버실에 두는 것입니다. 인터넷은 연결돼 있을 수 있습니다. 폐쇄망은 거기서 한 걸음 더 나가 외부 네트워크와 분리한 망입니다. 물리적으로 케이블조차 안 이어진 상태를 Air Gap(공기 틈)이라고 부릅니다. 국내 금융권의 망분리 규정, 공공기관 내부망, 방산·연구소가 대표적입니다.
그럼 이 환경에서 뭐가 안 될까요? OpenAI·Anthropic API 를 호출할 수 없습니다. 데이터가 밖으로 나가면 안 되는 것도 있지만 애초에 나갈 선이 없습니다. 밖으로 나가는 트래픽(Egress)이 0 인 상태입니다. 그래서 RAG 를 구성하는 모든 부품이 망 안에 있어야 합니다.
안에 있어야 하는 다섯 가지
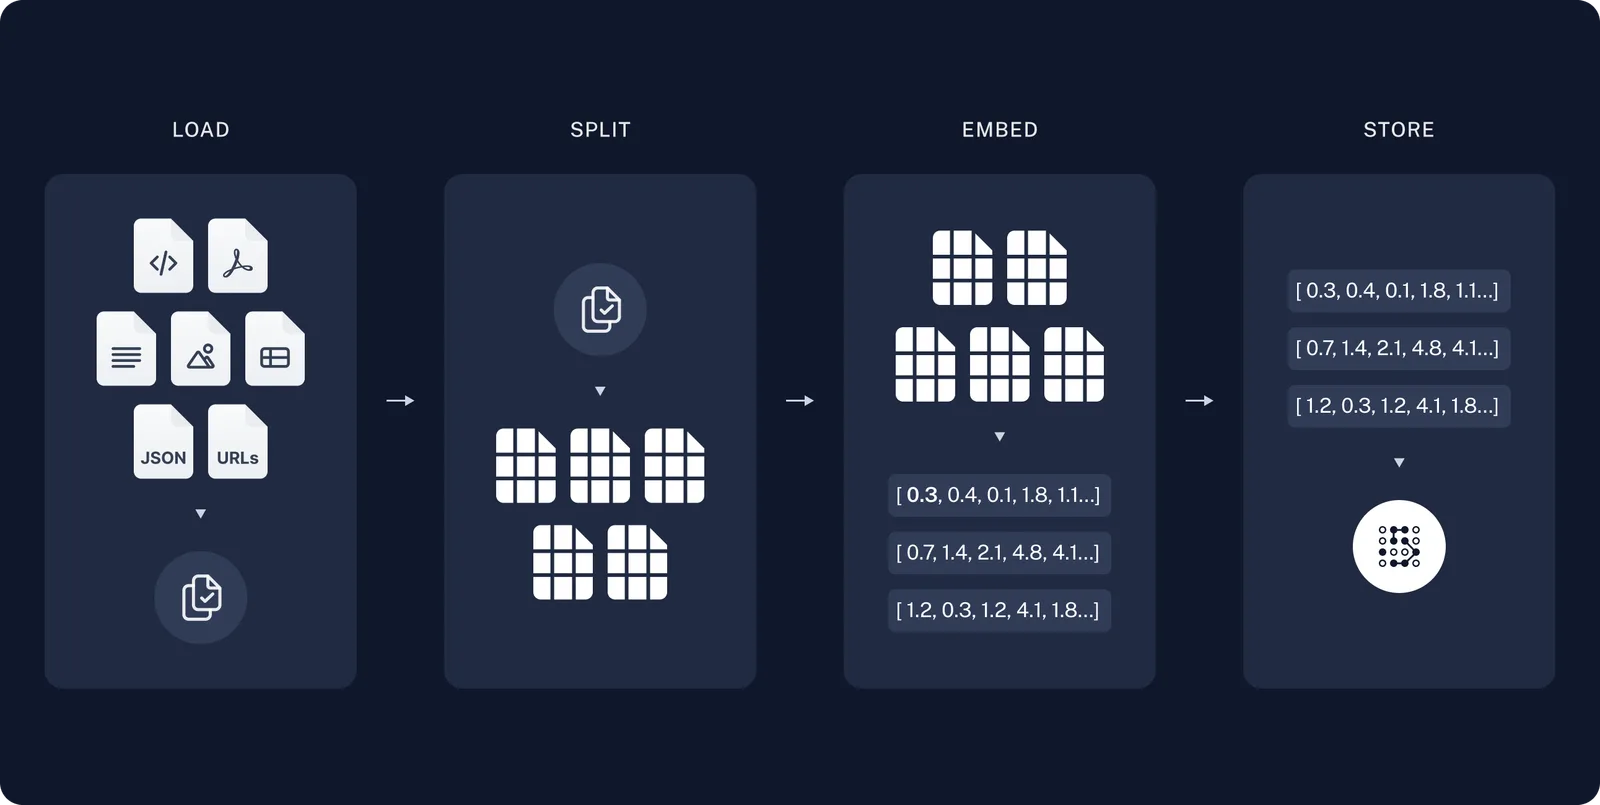
RAG 구조를 부품별로 나누면 다섯 가지가 나옵니다. 밖에서 쓰던 것과 안에서 대신 쓸 것을 비교해 보면 아래와 같습니다.
| 밖에서는 | 안에서는 | |
|---|---|---|
| LLM | OpenAI API | 내부 MaaS — vLLM 위에 오픈 모델 |
| 임베딩 모델 | OpenAI Embeddings API | 오픈 임베딩 모델을 같은 GPU 에 |
| 벡터 DB | 관리형 서비스 | pgvector·Milvus 를 직접 운영 |
| 컨테이너 이미지 | Docker Hub·NGC 에서 pull | 내부 레지스트리에 미러 |
| 패키지 | PyPI·npm | 내부 미러(Nexus·Artifactory) |
LLM 과 임베딩 모델은 Hugging Face 에서 받는 오픈 모델이어야 합니다. Qwen2.5-7B 처럼 라이선스가 Apache-2.0 인 모델이 반입 심사에서 편합니다. 벡터 DB 는 이미 Postgres 를 쓰고 있다면 pgvector 가 반입할 게 가장 적습니다.
그럼 어떻게 들여올까요 — 반입
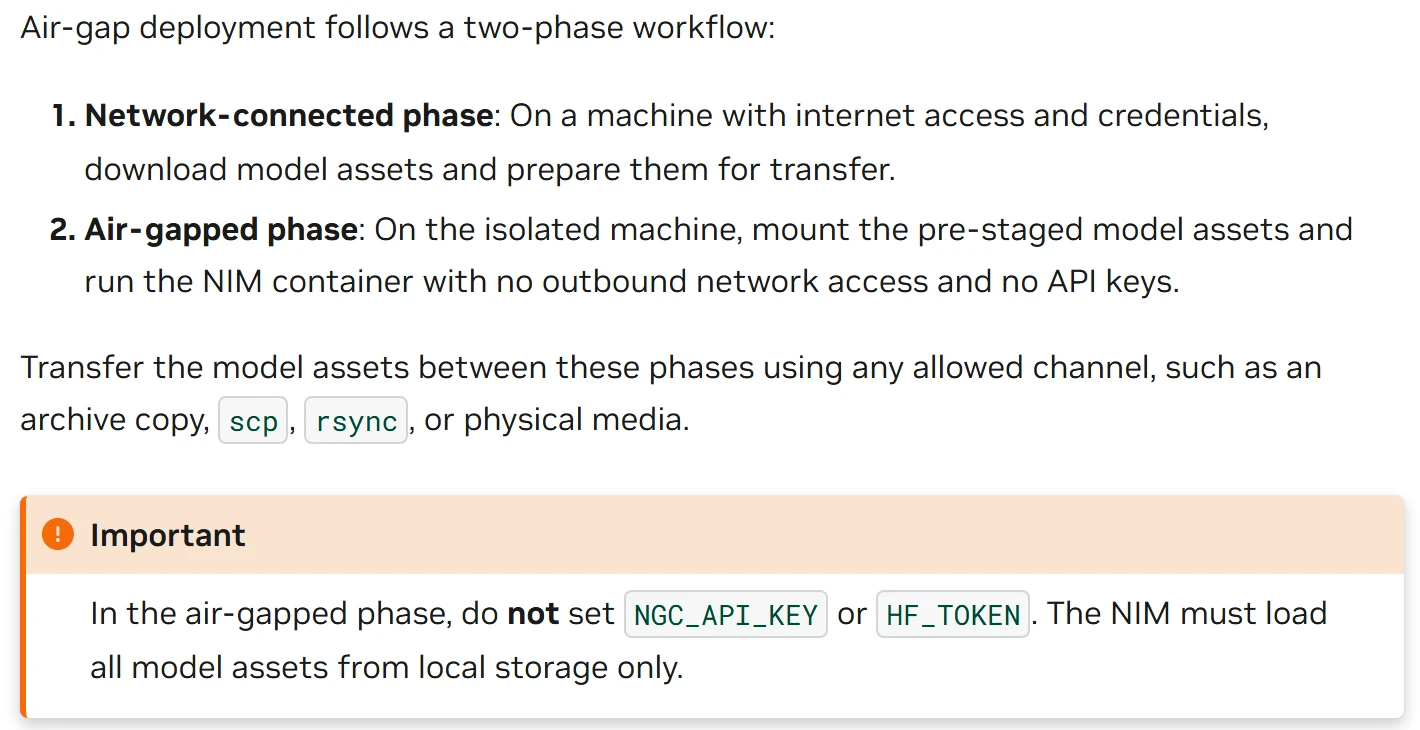
다섯 가지가 뭔지는 알았는데 실제로 어떻게 옮길까요? NVIDIA 의 NIM 문서가 이 절차를 두 단계로 적어 두고 있습니다. 인터넷이 되는 머신에서 받아 준비하고 격리된 머신에서 네트워크 없이 실행합니다.
실무 순서는 대체로 이렇습니다.
- 모델 파일 — 외부망 PC 에서
hf download Qwen/Qwen2.5-7B-Instruct로 safetensors 묶음을 받습니다. 임베딩 모델과 Reranker 도 같이 받습니다. - 컨테이너 이미지 —
docker pull vllm/vllm-openai한 뒤docker save로 tar 파일로 만듭니다. - 패키지 — Python 의존성을
pip download로 wheel 파일 묶음으로 받습니다. - 해시 기록 — 파일마다 SHA-256 을 적어 둡니다. 반입 심사에서 대조하고 나중에 SBOM 에 들어갑니다.
- 매체 이동 — USB·전용 전송 장비(망연계 솔루션)로 안쪽 망에 옮깁니다. 심사가 며칠 걸리는 조직도 있습니다.
- 내부 등록 — 이미지는 내부 레지스트리(Harbor 등)에
docker load후 push, 패키지는 내부 미러에 등록, 모델은 내부 스토리지에 둡니다.
안쪽 vLLM 은 HF_HUB_OFFLINE=1 을 켜고 로컬 경로에서 모델을 읽게 합니다. NIM 문서의 "Important" 상자가 말하는 그대로 — API 키를 넣지 말고 로컬 저장소에서만 읽습니다. 밖으로 나가려는 시도 자체가 없어야 합니다.
들어온 뒤의 구조
부품이 다 들어오면 구조 자체는 인터넷이 되는 환경의 MaaS·RAG 와 같습니다. 다른 점은 모든 화살표가 망 안에서 끝난다는 것뿐입니다.
사용자 질문은 내부 앱 → 내부 MaaS API → 임베딩 → 벡터 DB → LLM 을 거쳐 돌아옵니다. 어느 단계에서도 망 밖으로 나가는 호출이 없습니다. 인프라 팀이 이 그림을 한 번 세우면 각 부서는 API 주소만 받아 씁니다.
인터넷이 끊겼다고 유출 걱정이 끝날까요
아닙니다. 망 안에서도 부서 간 경계가 있습니다. 인사팀 문서를 색인한 벡터 DB 를 영업팀이 검색하면 안 됩니다. 벡터 DB 에 문서마다 접근 권한을 태그로 붙이고 검색할 때 사용자 권한으로 거르는 것이 기본입니다. 프롬프트와 답변 로그도 남기되 어디에 얼마나 보관할지를 정해 둬야 합니다.
모델 자체도 점검 대상입니다. safetensors 형식이 널리 쓰이는 이유 중 하나가 이것입니다. 예전 PyTorch 의 .bin(pickle) 형식은 파일을 여는 순간 임의 코드가 실행될 수 있어 반입 심사에서 꺼립니다. safetensors 는 숫자 표만 담고 코드를 담지 않습니다.
가장 어려운 건 첫 구축이 아니라 갱신
폐쇄망 운영에서 제일 힘든 게 뭘까요? 저는 첫 구축일 거라고 생각했는데 실제로는 갱신입니다. vLLM 이 취약점을 고쳐 새 버전을 내면 그 이미지를 다시 받아 심사하고 반입해야 합니다. 밖에서는 docker pull 한 줄인 일이 안에서는 며칠짜리 절차입니다. 모델도 마찬가지입니다. 새 모델이 나올 때마다 15GB 를 옮깁니다.
그래서 "지금 안에 뭐가 들어와 있는가"를 목록으로 갖고 있어야 합니다. 이미지 안의 패키지 버전, 모델 파일의 해시, 그 패키지들의 알려진 취약점. 이 목록이 SBOM(Software Bill of Materials)입니다. 반입 단계에서 적어 둔 해시가 그 출발점입니다.
여기까지가 LLM 을 회사 안에서 돌리는 인프라의 큰 그림입니다. 그럼 그 LLM 에 넣을 데이터는 어디에 어떻게 쌓여 있을까요? 다음 글부터는 방향을 바꿔 데이터 플랫폼에 대해서 알아보겠습니다.