Hugging Face 모델 이름 뒤에 붙는 7B·70B 의 B 는 파라미터 개수입니다. 그 76억 개 숫자가 파일 어디에 어떻게 들어 있는지 실제 모델 파일을 열어 확인하고 학습·추론·벡터 DB 와 어떻게 이어지는지 정리했습니다.
Hugging Face 에서 모델을 고르다 보면 이름 뒤에 7B, 14B, 70B 같은 숫자가 꼭 붙어 있습니다. 저도 처음엔 이게 파일 크기인 줄 알았습니다. 그런데 7B 모델을 받아 보면 15GB 가 넘습니다. 그럼 이 B 는 뭘까요? 파라미터 개수입니다. B 는 Billion 이고 7B 면 70억 개라는 뜻입니다. 이 숫자가 어디에 들어 있고 왜 그렇게 큰지를 보면 LLM 이라는 게 실제로 뭔지 잡힙니다.
먼저 용어부터 — AI·머신러닝·딥러닝·LLM
B 를 설명하려면 "모델"이 뭔지부터 잡아야 하는데 그 앞에 용어 네 개가 서로 어떻게 포개지는지 한 번만 정리하겠습니다.
AI 가 가장 넓은 말입니다. 그 안에 데이터에서 규칙을 스스로 찾아내는 머신러닝이 있습니다. 머신러닝 중에서 층을 여러 겹 쌓은 신경망을 쓰는 갈래가 딥러닝입니다. 딥러닝으로 만든 모델 가운데 글을 읽고 쓰는 데 특화된 아주 큰 모델이 LLM(Large Language Model)입니다.
같은 구조를 작게 만든 것은 SLM(Small Language Model)이라고 부릅니다. 경계는 느슨한데 대체로 수억~수십억 파라미터를 SLM 으로 봅니다. Qwen2.5-0.5B, Phi-4-mini(3.8B) 같은 모델이 여기 들어갑니다. 노트북이나 폰에서 돌리는 게 목적이라 크기가 곧 정체성인 모델들입니다.
모델은 결국 숫자 묶음입니다
그럼 "모델"은 뭘까요? 머신러닝에서 모델은 입력을 받아 출력을 내는 함수입니다. 함수의 모양은 코드가 정하고 함수 안의 값은 파라미터가 정합니다. 파라미터는 학습으로 정해진 숫자 하나하나를 말합니다. 그중 입력에 곱해지는 숫자를 가중치(Weight), 더해지는 숫자를 바이어스(Bias)라고 나눠 부르는데 실무에서는 둘을 합쳐 그냥 가중치라고 부릅니다.
이름 뒤의 7B·14B·70B 는 이 파라미터가 몇 십억 개인지를 뜻합니다. Hugging Face 가 Qwen2.5-7B 파일을 읽어 센 실제 개수는 7,615,616,512 개입니다. 7B 는 반올림한 이름이고 진짜는 76억 개입니다.
그 숫자는 파일 안에 어떻게 들어 있을까요
말로만 하면 추상적이니 실제 파일을 열어 보겠습니다. Hugging Face 는 .safetensors 파일 안의 내용을 브라우저에서 바로 보여 줍니다.
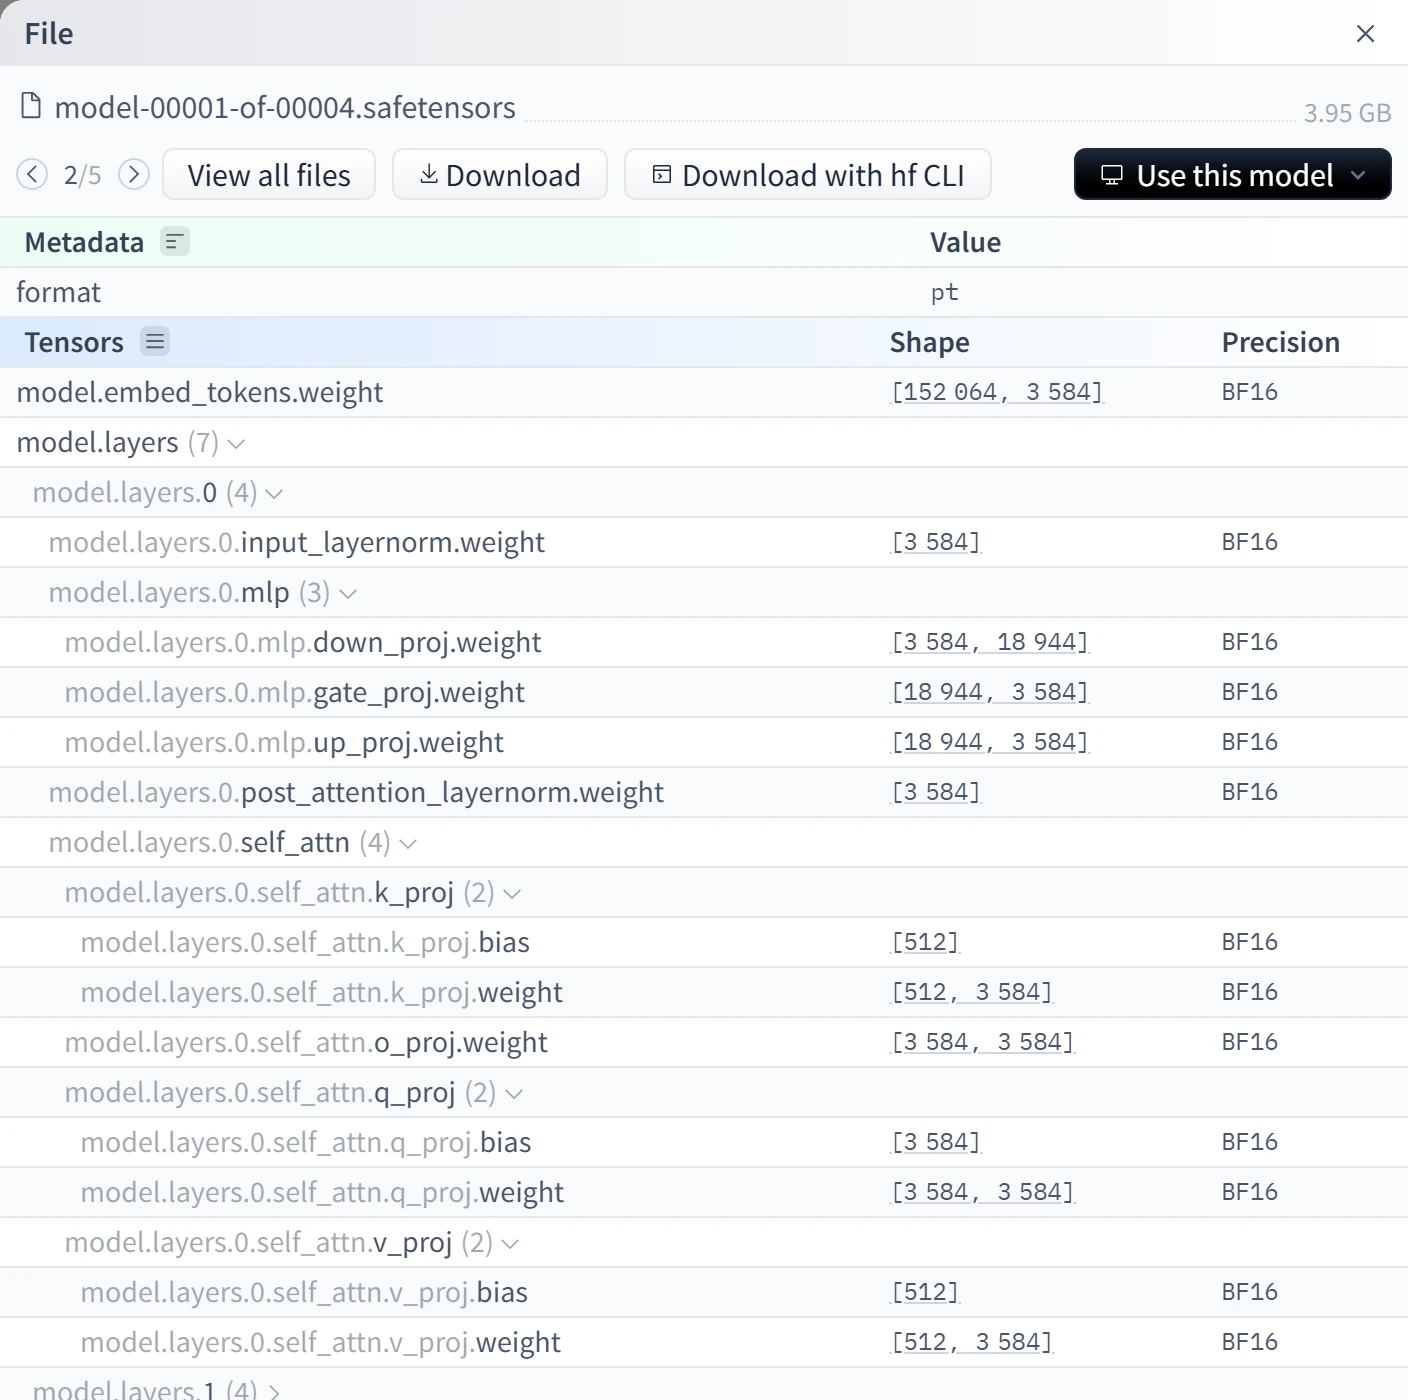
파일 안에는 이름이 붙은 숫자 표(텐서)가 줄지어 있습니다. model.embed_tokens.weight 는 [152064, 3584] 크기입니다. 어휘 152,064 개마다 3,584 개 숫자가 붙은 표라는 뜻입니다. 이 표 하나만 5억 4천만 개입니다. 그 아래 model.layers.0 부터 model.layers.27 까지 같은 구조의 층이 28개 반복됩니다. 층마다 q_proj·k_proj·v_proj·o_proj·mlp 라는 표가 들어 있는데 이 이름들은 Transformer 의 부품 이름인데 문장을 읽는 원리를 다루는 글에서 따로 설명합니다.
정밀도 칸의 BF16 은 숫자 하나를 2바이트로 저장한다는 뜻입니다. 그러면 계산이 됩니다. 76억 개 × 2바이트 ≈ 15.2GB. 파일 목록의 총 용량과 정확히 맞습니다. 제가 처음에 파일 크기라고 오해했던 그 숫자가 사실은 "파라미터 수 × 바이트"였던 겁니다.
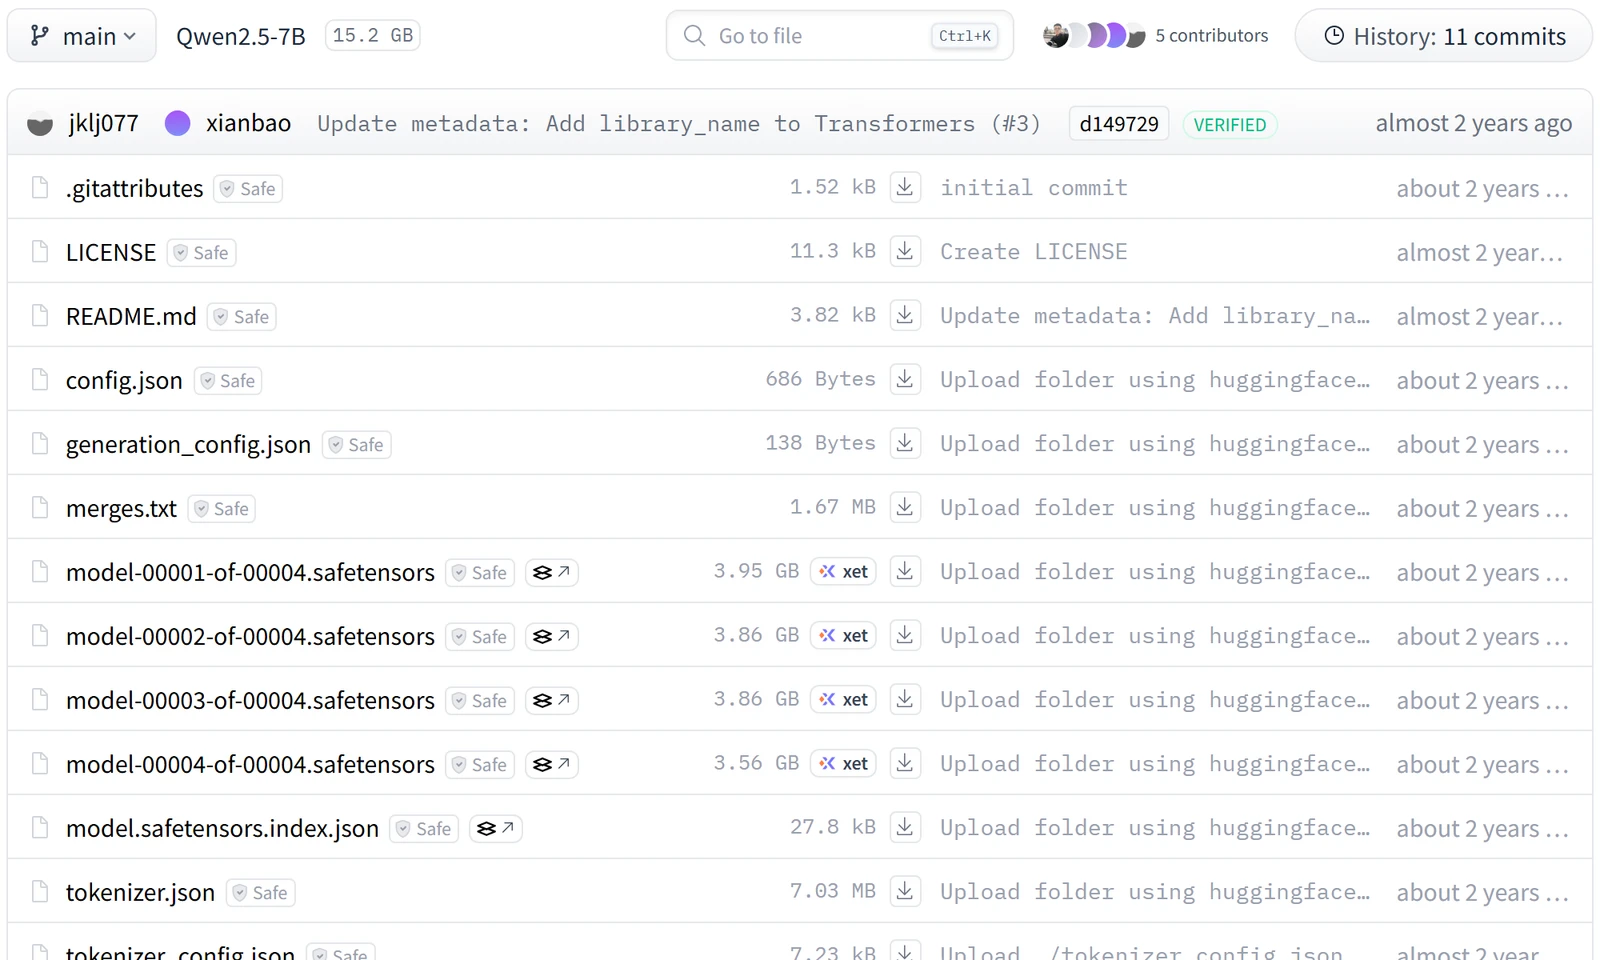
가중치 말고 같이 들어있는 파일도 있습니다. config.json 은 층 수·차원 같은 함수의 모양을 적은 686바이트짜리 설계도입니다. tokenizer.json 은 글자를 숫자로 바꾸는 사전이고 generation_config.json 은 생성 기본값입니다. 셋을 합쳐도 10MB 가 안 됩니다. 그러니까 모델 크기는 사실상 가중치 크기입니다.
파라미터가 많으면 왜 모델이 커질까요
70B 는 7B 의 열 배인데 뭐가 열 배일까요? 파라미터가 늘어나는 경로는 두 가지입니다. 층을 더 쌓거나(28층 → 80층), 한 층의 폭을 넓히거나(3,584 → 8,192)입니다. 폭을 두 배로 넓히면 표의 가로세로가 함께 늘어 숫자는 네 배가 됩니다. 그래서 70B 는 7B 보다 층도 많고 폭도 넓습니다.
파라미터 하나가 2바이트를 차지하니 용량은 파라미터 수에 정비례합니다. 70B 모델은 BF16 으로 약 140GB 입니다. 이건 GPU 한 장에 들어가지 않는 크기입니다. 이 문제는 숫자 하나의 바이트를 줄이거나(양자화) 여러 GPU 에 나눠 싣는 방법으로 풉니다. 각각 별도 글에서 다룹니다.
학습은 숫자를 고치는 일, 추론은 숫자를 쓰는 일
그럼 이 76억 개 숫자는 누가 정했을까요? 학습(Training)이 정합니다. 처음에는 전부 무작위 값입니다. 문장을 넣고 다음 단어를 맞히게 한 뒤, 틀린 만큼 숫자를 아주 조금씩 고칩니다. 이 과정을 수조 개 토큰에 대해 반복하면 지금의 값이 됩니다. 바뀌는 것은 파라미터의 값뿐이고 모양(구조)은 그대로입니다.
추론(Inference)은 정해진 숫자를 읽기만 하는 과정입니다. 입력이 들어오면 저 표들에 차례로 곱하고 더해 다음 토큰 하나를 내놓습니다. 숫자를 고치지 않으니 학습보다 훨씬 쌉니다. 우리가 쓰는 서비스는 전부 추론입니다. 이 추론을 어떻게 빠르고 싸게 하느냐가 LLM 인프라의 대부분입니다.
파라미터와 벡터 DB 는 다른 것
"우리 회사 문서를 모델에 넣는다"는 말을 들으면 이 파라미터에 문서가 들어가는 걸로 생각하기 쉽습니다. 저도 그렇게 이해하고 있었는데 아닙니다. 파라미터는 학습이 끝나면 고정됩니다. 그 안에 특정 문서가 문장 형태로 들어 있지 않습니다. 학습 데이터의 통계적 흔적만 숫자에 녹아 있을 뿐입니다. 파라미터에 새 지식을 넣으려면 다시 학습(파인튜닝)해야 합니다.
벡터 DB 는 모델 바깥에 있는 별도 저장소입니다. 문서를 조각내 숫자 벡터로 바꿔 넣어 둡니다. 질문이 오면 비슷한 조각을 찾아 모델에 함께 건넵니다. 모델의 파라미터는 하나도 바뀌지 않습니다. 이 방식이 RAG 입니다. 둘을 비교해 보면 아래와 같습니다.
| 파라미터 | 벡터 DB | |
|---|---|---|
| 어디에 | 모델 파일 안 | 모델 밖 별도 저장소 |
| 무엇이 | 학습으로 정해진 숫자 | 문서 조각의 임베딩 |
| 바꾸려면 | 재학습·파인튜닝 | 문서 추가·삭제 |
| 갱신 비용 | GPU 시간 | 인덱싱 몇 초 |
여기까지 정리하면
모델 파일은 이름 붙은 숫자 표들의 묶음이고 7B 는 그 숫자가 76억 개라는 뜻입니다. 학습은 그 숫자를 고치는 일이고 추론은 그 숫자를 곱해 쓰는 일입니다. 그럼 이 숫자 표들이 어떻게 문장을 읽고 다음 단어를 고를까요? 다음 글에서 Transformer 와 Attention 에 대해서 알아보겠습니다.
참고 자료
- 모델 저장소: Qwen/Qwen2.5-7B — Hugging Face (파일 목록·safetensors 뷰어 화면 캡처, Apache-2.0)
- Safetensors — Hugging Face Docs