모델이 GPU 한 장에 안 들어가거나, 요청이 서버 한 대를 넘거나, GPU 가 남을 때 기업이 세우는 층 — Tensor Parallel·Kubernetes·MIG·llm-d — 이 각각 무슨 문제를 푸는지 정리했습니다.
vLLM 같은 추론 엔진 한 개는 GPU 한 장(또는 서버 한 대)을 관리합니다. 그런데 회사에서는 곧 이런 상황이 옵니다. 모델이 한 장에 안 들어가거나, 사용자가 서버 한 대로 감당이 안 되거나, 반대로 GPU 가 남아서 여러 팀이 나눠 써야 하거나. 저는 이 세 가지가 전부 "Kubernetes 로 해결"인 줄 알았는데 실제로는 문제마다 도구가 다릅니다. GPU 를 묶는 건 Tensor Parallel, 서버를 묶는 건 Kubernetes, GPU 를 쪼개는 건 MIG 이고 그 앞에서 요청을 나누는 게 llm-d 입니다.
서버 한 대를 넘어서면 생기는 세 가지 문제
- 모델이 GPU 한 장보다 큽니다. 70B 모델은 BF16 으로 140GB 라서 H100 80GB 두 장으로도 모자랍니다.
- 요청이 서버 한 대보다 많습니다. vLLM 을 여러 개 띄우고 요청을 나눠 줘야 합니다.
- GPU 가 남습니다. 작은 모델 하나가 H100 80GB 를 독점하면 나머지는 놀립니다.
첫 번째는 GPU 를 묶는 일, 두 번째는 서버를 묶는 일, 세 번째는 GPU 를 쪼개는 일입니다. 각각 도구가 다릅니다.
한 모델을 GPU 여러 장에 나누는 Tensor Parallel
모델이 한 장에 안 들어가면 가중치 표를 잘라 여러 GPU 에 나눠 싣습니다. 모델 파일 안의 q_proj.weight 같은 표를 세로로 반 갈라 GPU 0·1 에 한 조각씩 두고 계산도 각자 한 뒤 결과만 합칩니다. 이 방식이 Tensor Parallel 입니다. 층마다 GPU 사이 통신이 생기니 NVLink 처럼 빠른 연결이 있는 같은 서버 안에서 주로 씁니다. vLLM 에서는 --tensor-parallel-size 4 옵션 하나로 켭니다.
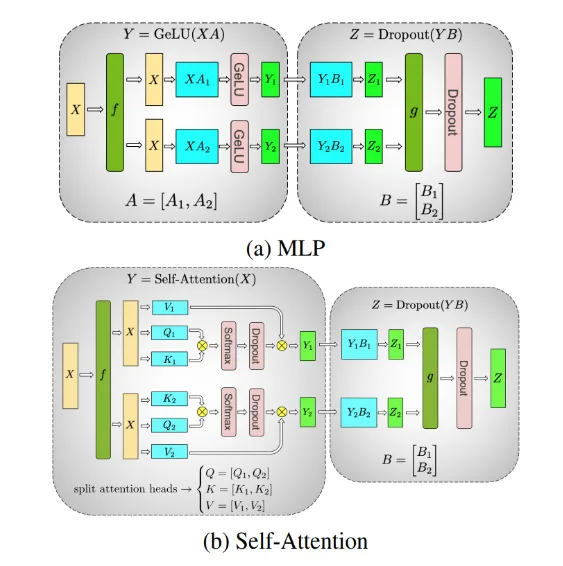
반대로 모델이 한 장에 들어가지만 요청이 많을 때는 Data Parallel 을 씁니다. 같은 모델을 GPU 마다 통째로 복사해 두고 요청을 나눠 줍니다. 이건 사실상 vLLM 을 여러 개 띄우는 것이라 서버를 묶는 층으로 넘어갑니다.
서버 여러 대를 하나처럼 묶는 Kubernetes
Kubernetes 는 서버 여러 대에 컨테이너를 배치하고 관리하는 시스템입니다. 배울 게 많은 도구지만 LLM 서빙에서 필요한 개념은 네 가지면 됩니다.
| 역할 | LLM 서빙에서는 | |
|---|---|---|
| Pod | 컨테이너 실행 단위 | vLLM 프로세스 하나 + GPU 할당 |
| Service | Pod 묶음의 고정 주소 | vLLM Pod 여러 개를 하나의 내부 주소로 |
| Ingress | 클러스터 밖에서 들어오는 문 | 사용자 요청이 들어오는 HTTPS 입구 |
| Egress | 클러스터 밖으로 나가는 통로 | 모델 다운로드·외부 API 호출 (폐쇄망에서는 이게 0) |
Ingress 뒤에 Load Balancer 가 있어서 요청을 Pod 들에 나눠 줍니다. 일반 웹 서비스라면 순서대로 돌리는(round-robin) 방식이면 충분한데, LLM 은 그렇지 않습니다. 왜 그런지가 llm-d 가 생긴 이유입니다. 그 전에 세 번째 문제부터 정리하겠습니다.
GPU 한 장을 최대 7개로 쪼개는 MIG
세 번째 문제는 방향이 반대입니다. GPU 가 남습니다. NVIDIA 의 A100·H100 은 MIG(Multi-Instance GPU)로 GPU 한 장을 최대 7개의 독립 인스턴스로 쪼갤 수 있습니다. 각 인스턴스는 자기 몫의 연산 유닛·L2 캐시·메모리를 갖고 서로 간섭하지 않습니다. H100 80GB 를 10GB 짜리 7개로 나누면 7B 양자화 모델 7개를 따로따로 돌릴 수 있습니다.
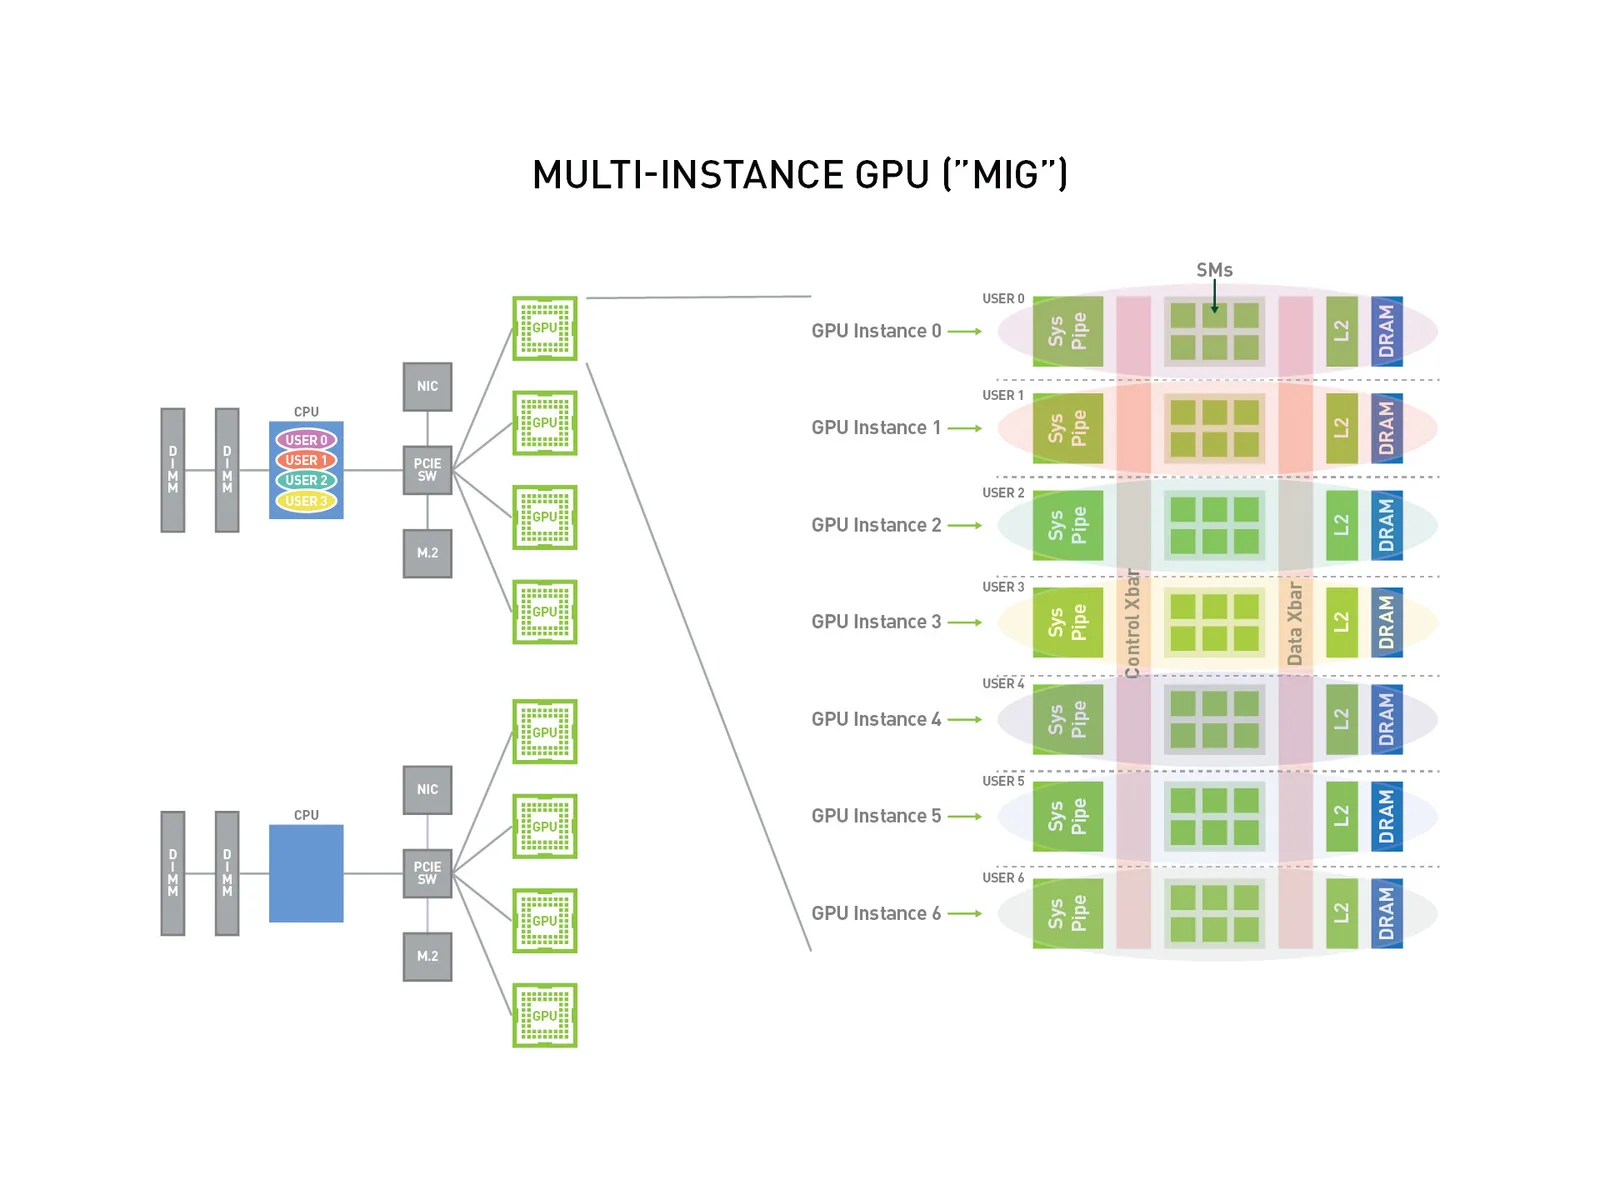
Kubernetes 는 MIG 인스턴스를 GPU 한 장처럼 취급해 Pod 에 배정합니다. 큰 모델에는 GPU 통째로, 작은 모델·실험용에는 MIG 조각을 주는 식으로 GPU 공유가 됩니다. 물리적으로 나누지 않고 시간을 나눠 쓰는 time-slicing 도 있지만 격리가 약해서 서비스용으로는 MIG 를 선호합니다.
LLM 요청을 아는 라우터 llm-d
이제 아까 미뤄 둔 질문입니다. 왜 일반 로드 밸런서로는 부족할까요? LLM 요청은 길이도 제각각이고 앞 토큰의 계산 결과를 저장해 둔 KV Cache 가 어느 Pod 에 남아 있느냐에 따라 같은 요청도 처리 시간이 크게 달라지기 때문입니다. 이걸 아는 라우터가 필요합니다.
llm-d 는 Red Hat 이 Google Cloud·IBM Research·CoreWeave·NVIDIA 와 함께 2025년 5월 20일 공개한 오픈소스 프로젝트입니다. 2026년 3월 KubeCon Europe 에서 CNCF 샌드박스 프로젝트로 기부됐습니다. 실행 엔진은 vLLM 그대로이고 llm-d 는 그 위에서 요청을 어느 vLLM 으로 보낼지를 정하는 층입니다.
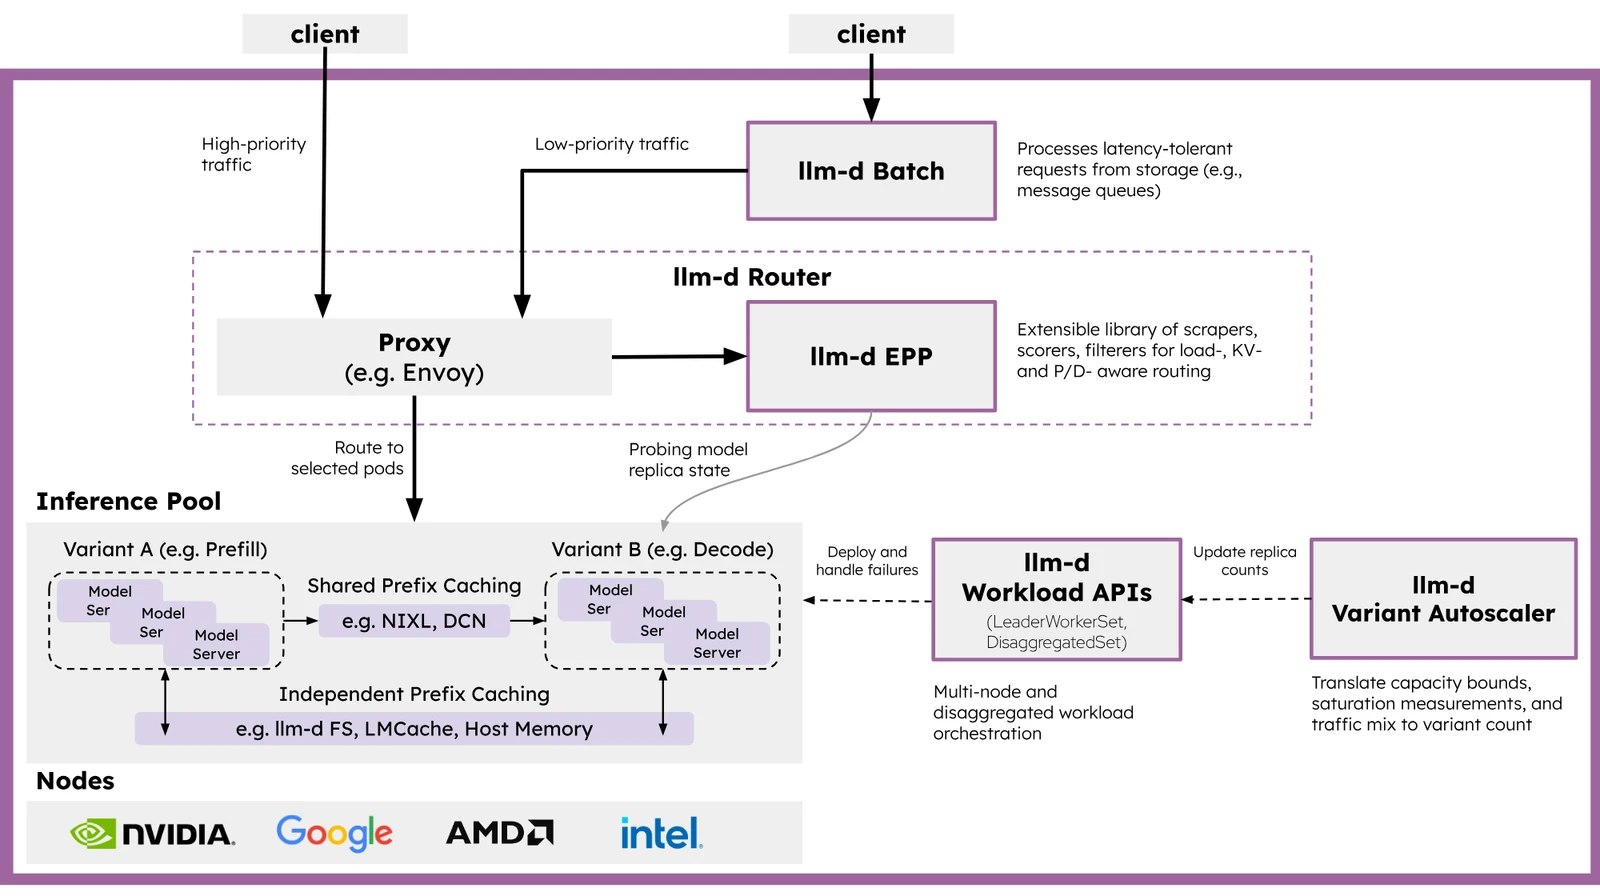
일반 로드 밸런서와 차이점은 세 가지가 있습니다.
KV Cache 를 아는 라우팅. 같은 시스템 프롬프트로 시작하는 요청이 오면, 그 프롬프트의 KV Cache 가 이미 있는 Pod 로 보냅니다. 프롬프트를 처음부터 계산하는 Prefill 단계를 통째로 건너뛸 수 있으니 첫 토큰이 빨라집니다. 그림의 EPP(Endpoint Picker)가 이 판단을 합니다.
Prefill/Decode 분리. LLM 추론에서 프롬프트를 한 번에 처리하는 Prefill 은 계산이, 토큰을 하나씩 만드는 Decode 는 메모리 대역폭이 병목입니다. 병목이 다르니 같은 GPU 에서 섞어 돌리면 서로 방해합니다. llm-d 는 Prefill 전용 Pod(그림의 Variant A)와 Decode 전용 Pod(Variant B)를 따로 두고 Prefill 이 만든 KV Cache 를 NIXL 같은 전송 계층으로 Decode 쪽에 넘깁니다. 각 Pod 는 자기 병목에 맞는 GPU·설정으로 튜닝할 수 있습니다.
부하 기반 오토스케일링. 요청 큐 길이·KV Cache 사용률 같은 LLM 지표로 Pod 수를 늘리고 줄입니다. 그림의 Variant Autoscaler 입니다.
CNCF 기부 발표 글은 대규모 모델 운영 환경에서 이 라우팅을 쓴 팀들이 round-robin 대비 출력 처리량 3배, TTFT 절반을 봤다고 적고 있습니다. 조건에 따라 다를 수치이니 방향만 참고하면 됩니다.
팀마다 서버를 안 세우는 MaaS
이 층을 다 세우고 나면 조직 안에서는 GPU·vLLM·llm-d 를 팀마다 따로 두지 않습니다. 인프라 팀이 한 번 세우면, 다른 팀은 vLLM 이 제공하는 OpenAI 호환 API 주소와 키만 받아 씁니다. 이 운영 형태가 MaaS(Model as a Service)입니다. 외부 API 를 쓰는 것과 사용 경험은 같은데 데이터가 회사 밖으로 나가지 않고 GPU 를 조직 전체가 공유합니다.
전체 그림을 한 줄로 이으면 이렇습니다. 사용자 → Ingress → llm-d Router → vLLM Pod → GPU(또는 MIG 조각) → 모델. 모델 파일의 76억 개 숫자가 이 경로 맨 끝에 있습니다.
여기까지가 모델을 "돌리는" 쪽 이야기입니다. 다음 글에서는 방향을 바꿔서 이 모델의 숫자 자체를 우리 회사에 맞게 고치는 Fine-tuning 과 LoRA 에 대해서 알아보겠습니다.