AI
AI 네이티브 시대에 개발자가 배워야 할 것
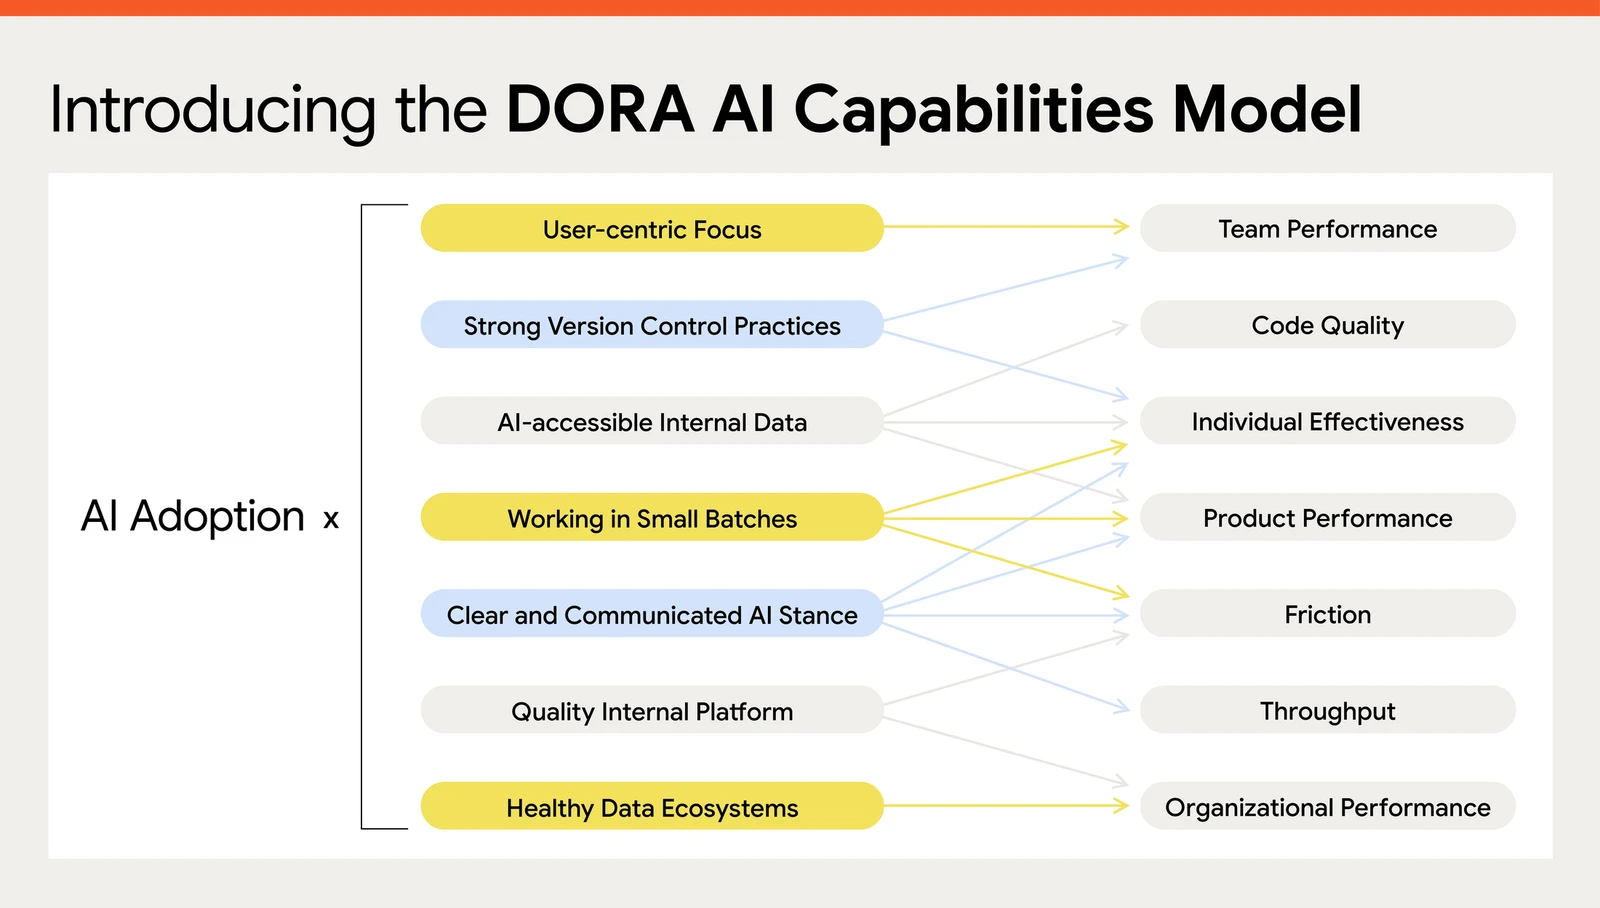
DORA 는 AI 가 조직의 강점과 약점을 그대로 증폭한다며 일곱 가지 역량을 조건으로 꼽았고 Karpathy 는 "생각은 맡길 수 있어도 이해는 맡길 수 없다"고 했습니다. 조직이 갖춰야 할 조건과 개발자 개인이 키워야 할 역량을 DORA·Microsoft·Stack Overflow 자료로 정리했습니다.
Orca 대신 Paseo 를 고르는 이유
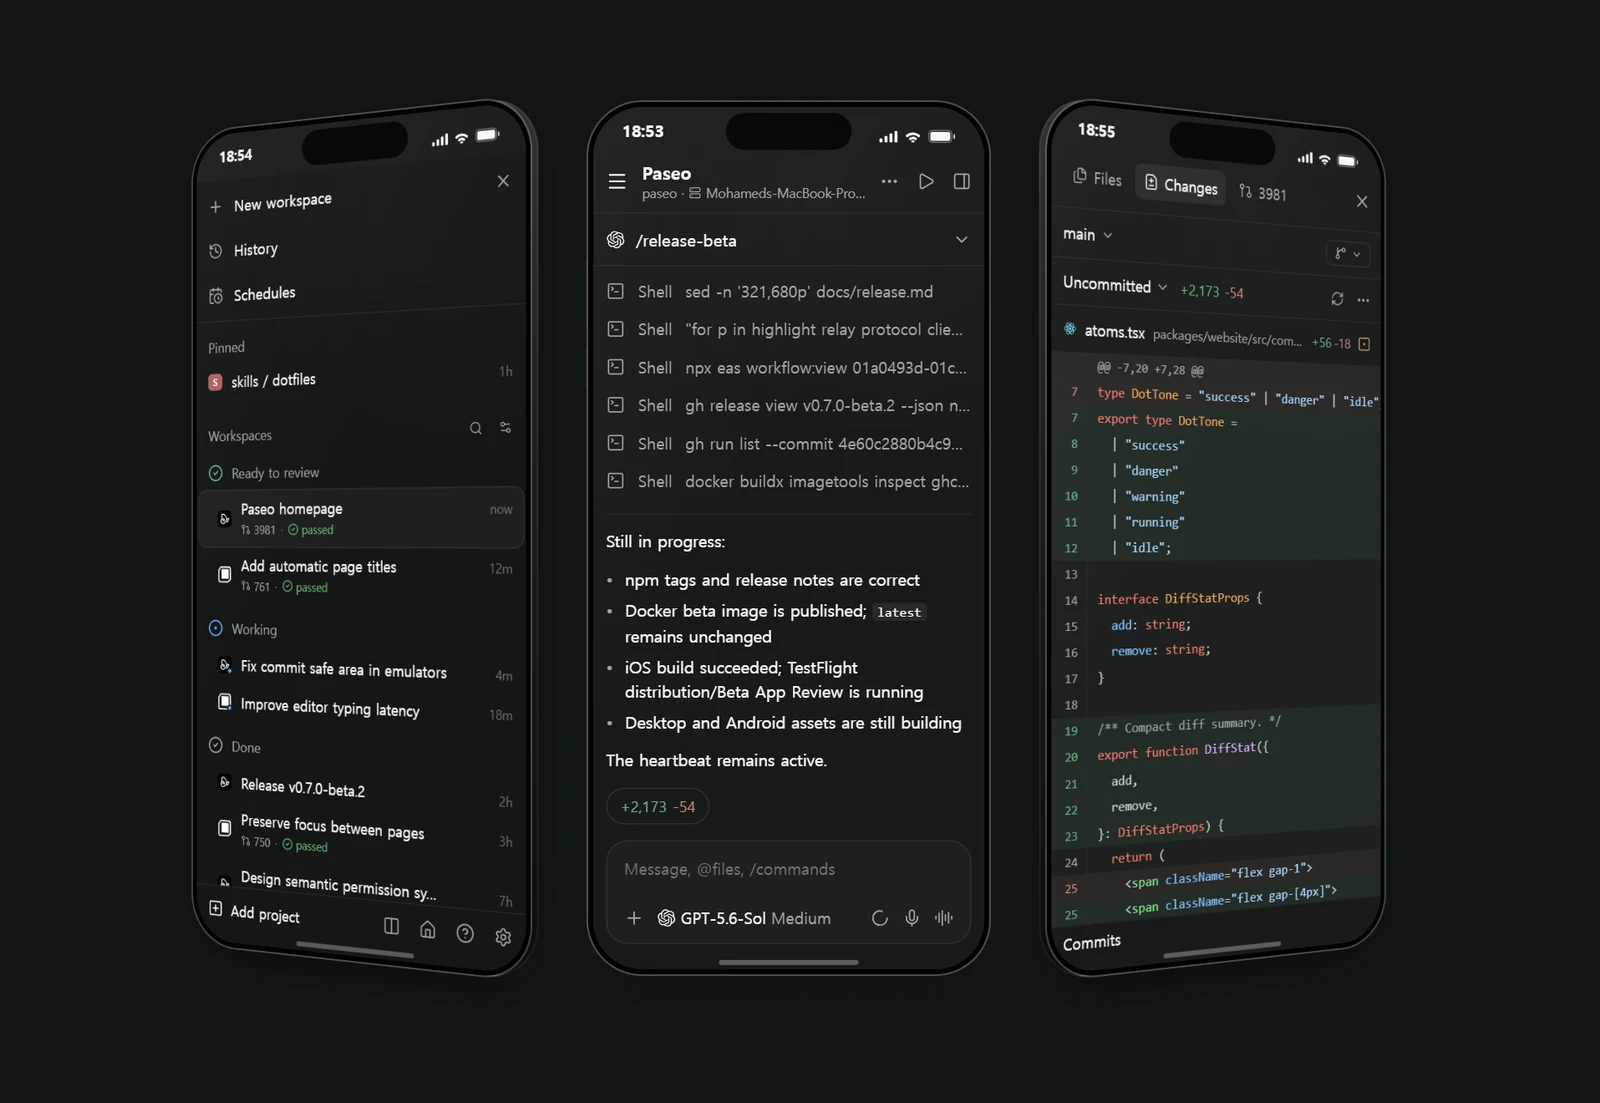
에이전트를 여러 개 동시에 실행하는 도구가 올해 두 갈래로 나뉘었습니다. Orca 는 데스크톱 앱 안에 브라우저·에디터·터미널을 전부 넣었습니다. Paseo 는 반대로 화면을 빼고 데몬 하나만 남겼습니다. GitHub Star 는 Orca 가 6만 7천, Paseo 가 1만 7천으로 네 배 가까이 차이 납니다. 그래도 고를 때 봐야 할 건 Star 수가 아니라 내 작업이 어디서 끝나느냐입니다.
sLLM 자체 구축, 정말 대세일까요?
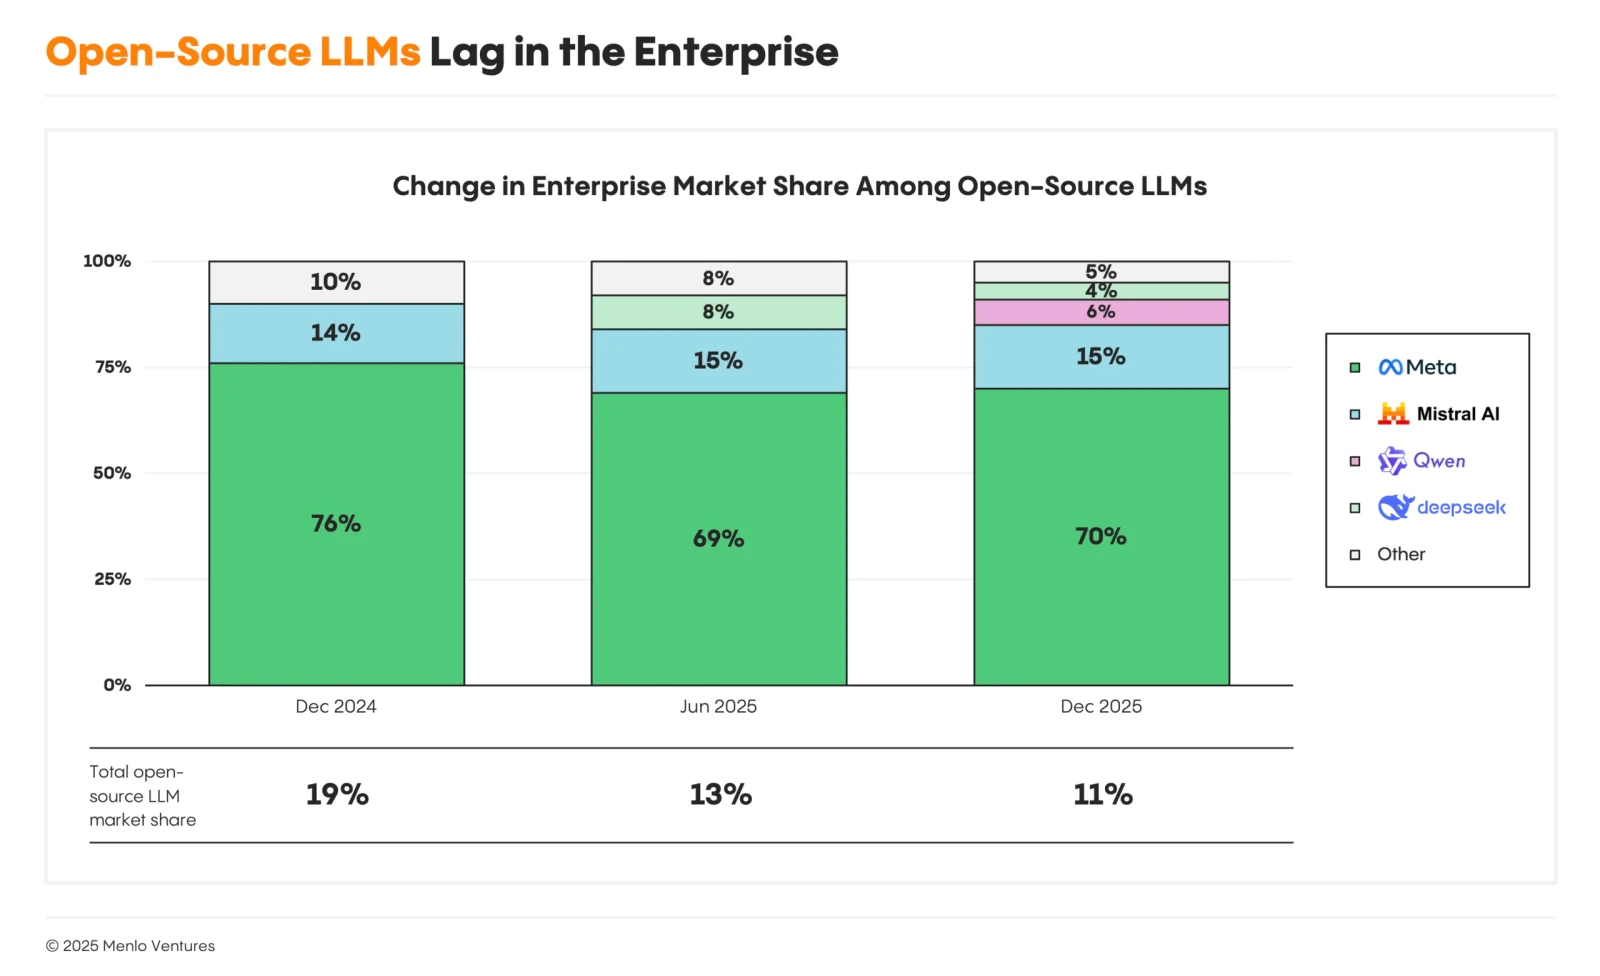
국내는 폐쇄망 규제와 정부의 독자 AI 파운데이션 모델 사업이 겹쳐 sLLM 자체 구축이 흐름이 됐는데, Menlo Ventures 가 집계한 세계 기업의 LLM 사용량에서 오픈소스 비중은 19% 에서 11% 로 줄었습니다. 두 숫자가 엇갈리는 이유와 코딩 에이전트에 붙일 수 있는 2026년의 오픈 웨이트 모델을 정리했습니다.
코딩 에이전트는 새로 입사한 직원처럼 다뤄야 한다
OWASP 는 2025년 12월에 에이전트 전용 Top 10 을 따로 냈고 Anthropic 은 내부 에이전트를 내부자 위협으로 취급해 감시합니다. 코딩 에이전트의 공격 표면과 샌드박스·권한 경계·감시·되먹임 네 층의 방어를 정리했습니다.
AI가 짠 PR은 왜 리뷰를 4.6배 오래 기다릴까?
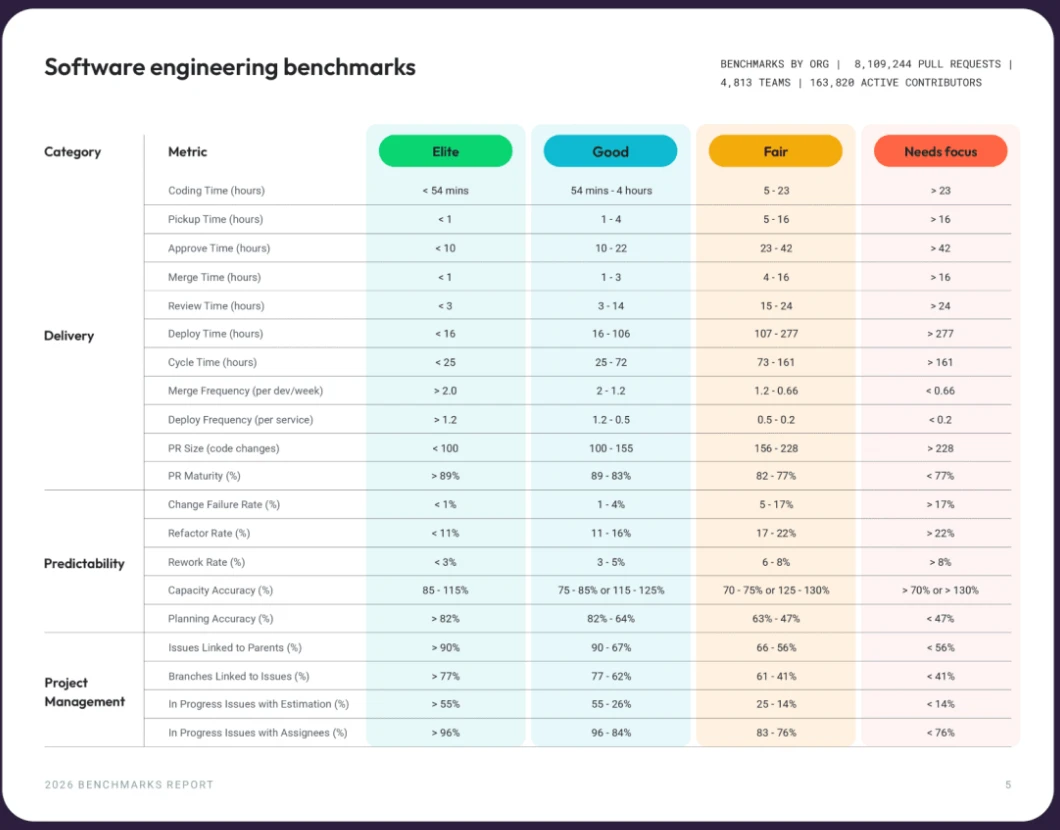
LinearB 가 PR 810만 건을 분석한 2026년 벤치마크에서 AI 가 만든 PR 은 첫 리뷰까지 4.6배 오래 기다렸고 승인률은 84.4% 대 32.7% 로 갈렸습니다. 병목의 크기와 AI 리뷰어·테스트 게이트·리스크 티어링이 그 병목을 어떻게 푸는지 정리했습니다.
AI 모델은 배포가 끝이 아니다
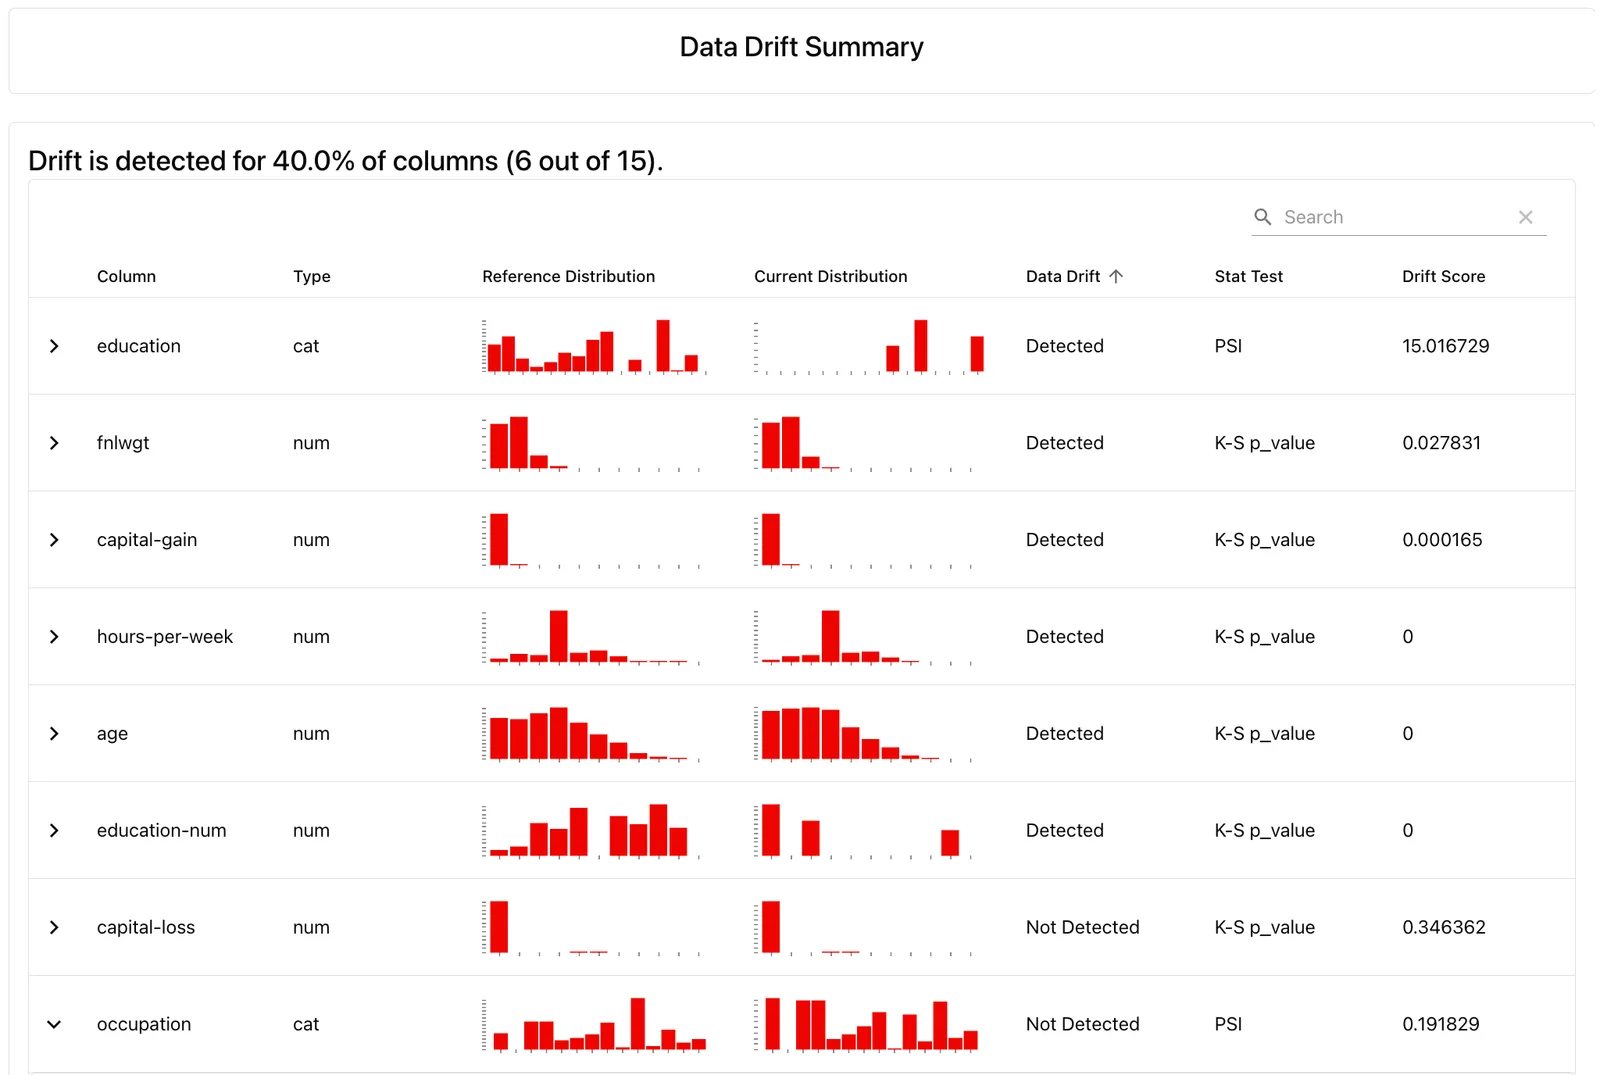
배포한 모델이 시간이 지나며 나빠지는 이유(Data Drift)와 그걸 재는 지표(Precision·Recall), 계속 돌리는 비용(TCO), 안에 뭐가 들었는지 아는 일(SBOM·SAST)까지 배포 이후의 운영을 정리했습니다.
SKILL.md 하나로 30개 도구가 같은 일을 하는 이유
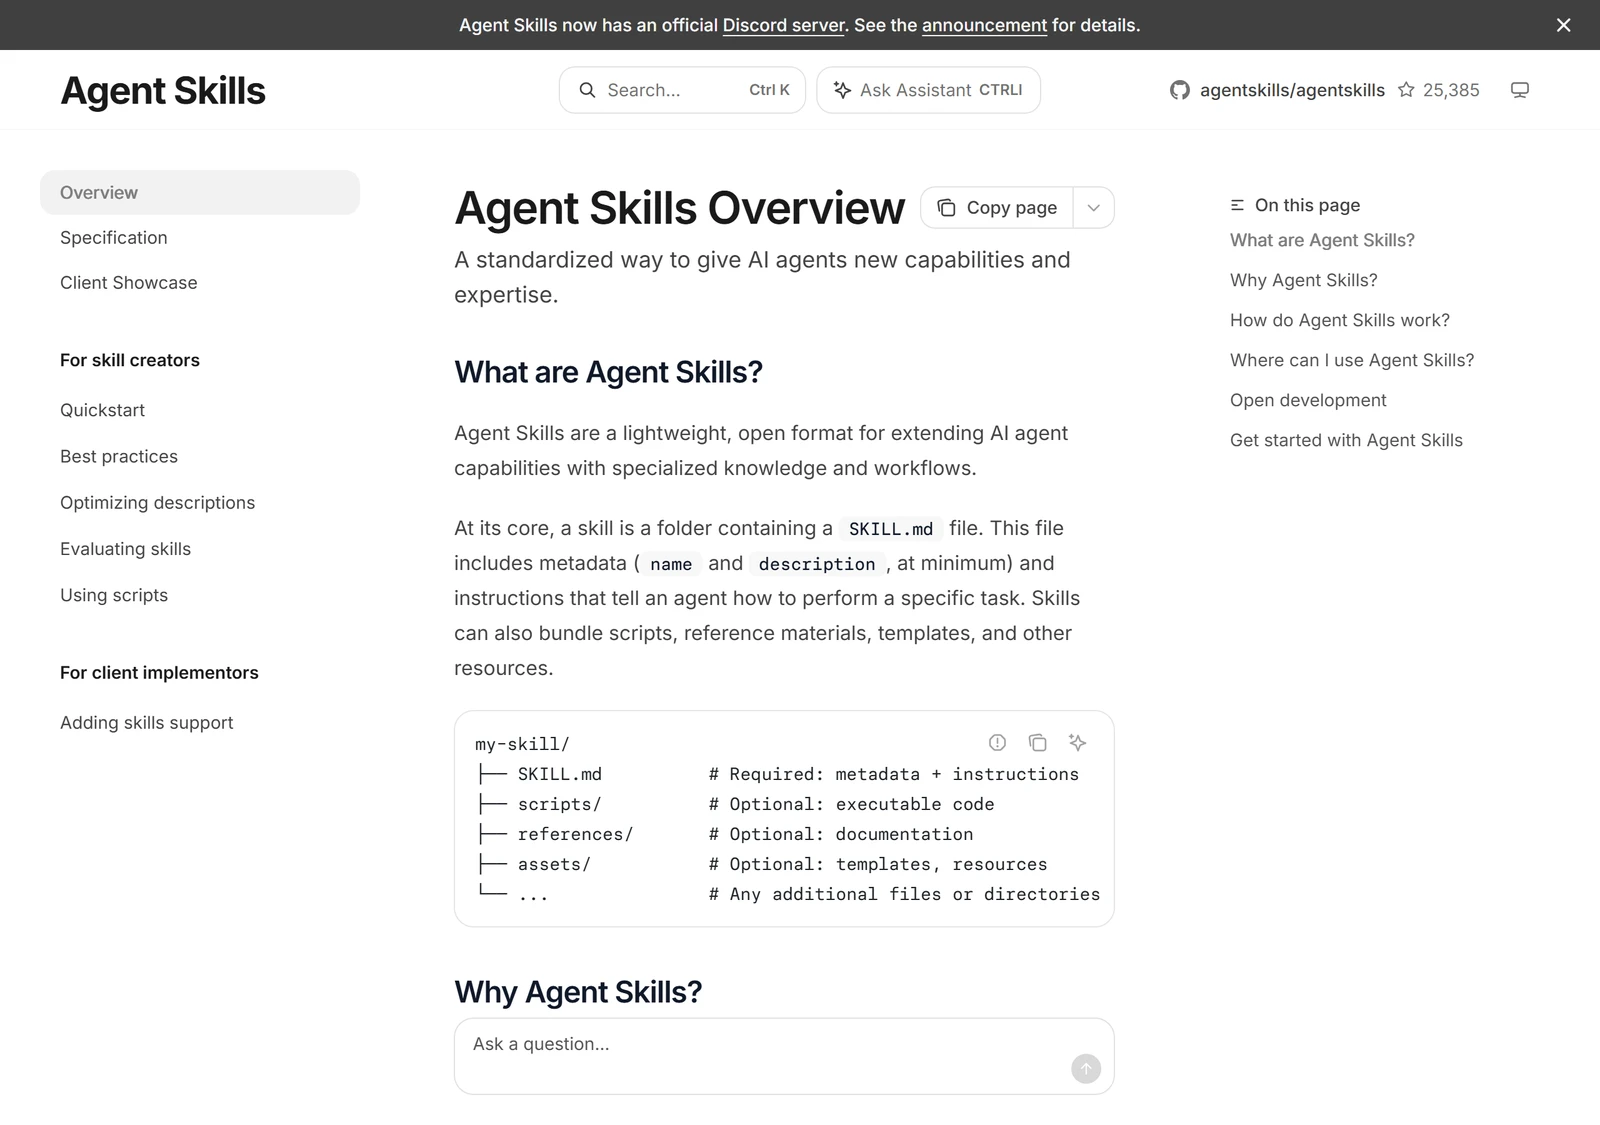
Anthropic 이 2025년 12월에 공개 표준으로 푼 형식을 Codex·Cursor·Gemini CLI·VS Code·Kiro 등 30개가 넘는 도구가 그대로 받아들였습니다. 스킬이 왜 그렇게 퍼졌는지, 서브에이전트·훅과 어떻게 역할을 나누는지, 어떤 규칙을 어디에 둘지 표로 정리했습니다.
MCP는 왜 AI의 USB-C라고 불릴까?
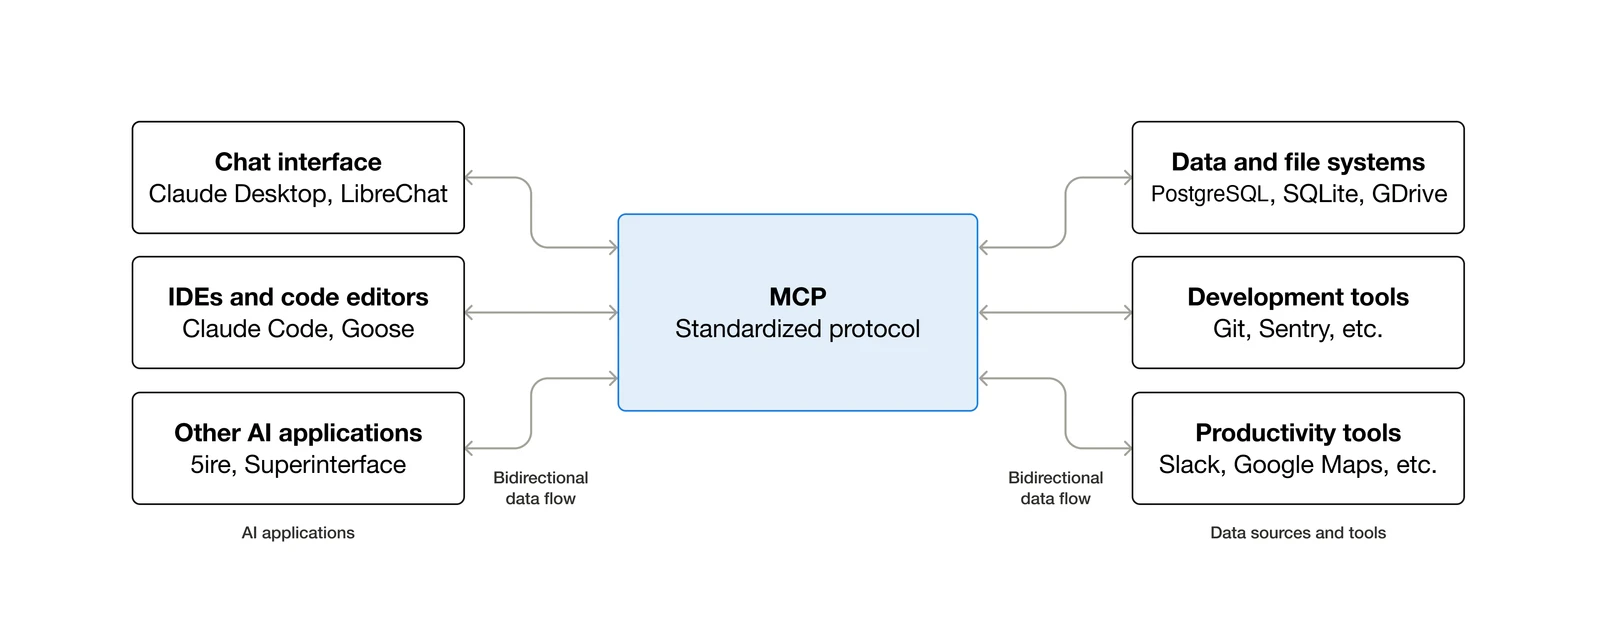
2025년 12월 Linux Foundation 으로 넘어갈 당시 공개 MCP 서버는 1만 개, SDK 월간 다운로드는 9,700만 건이었습니다. 에이전트가 GitHub·DB·Figma 같은 바깥 세계와 대화하는 이 표준의 구조와 2026년 레지스트리, 서버를 붙일 때 볼 것을 정리했습니다.
컨텍스트 엔지니어링이 프롬프트 엔지니어링과 다른 점
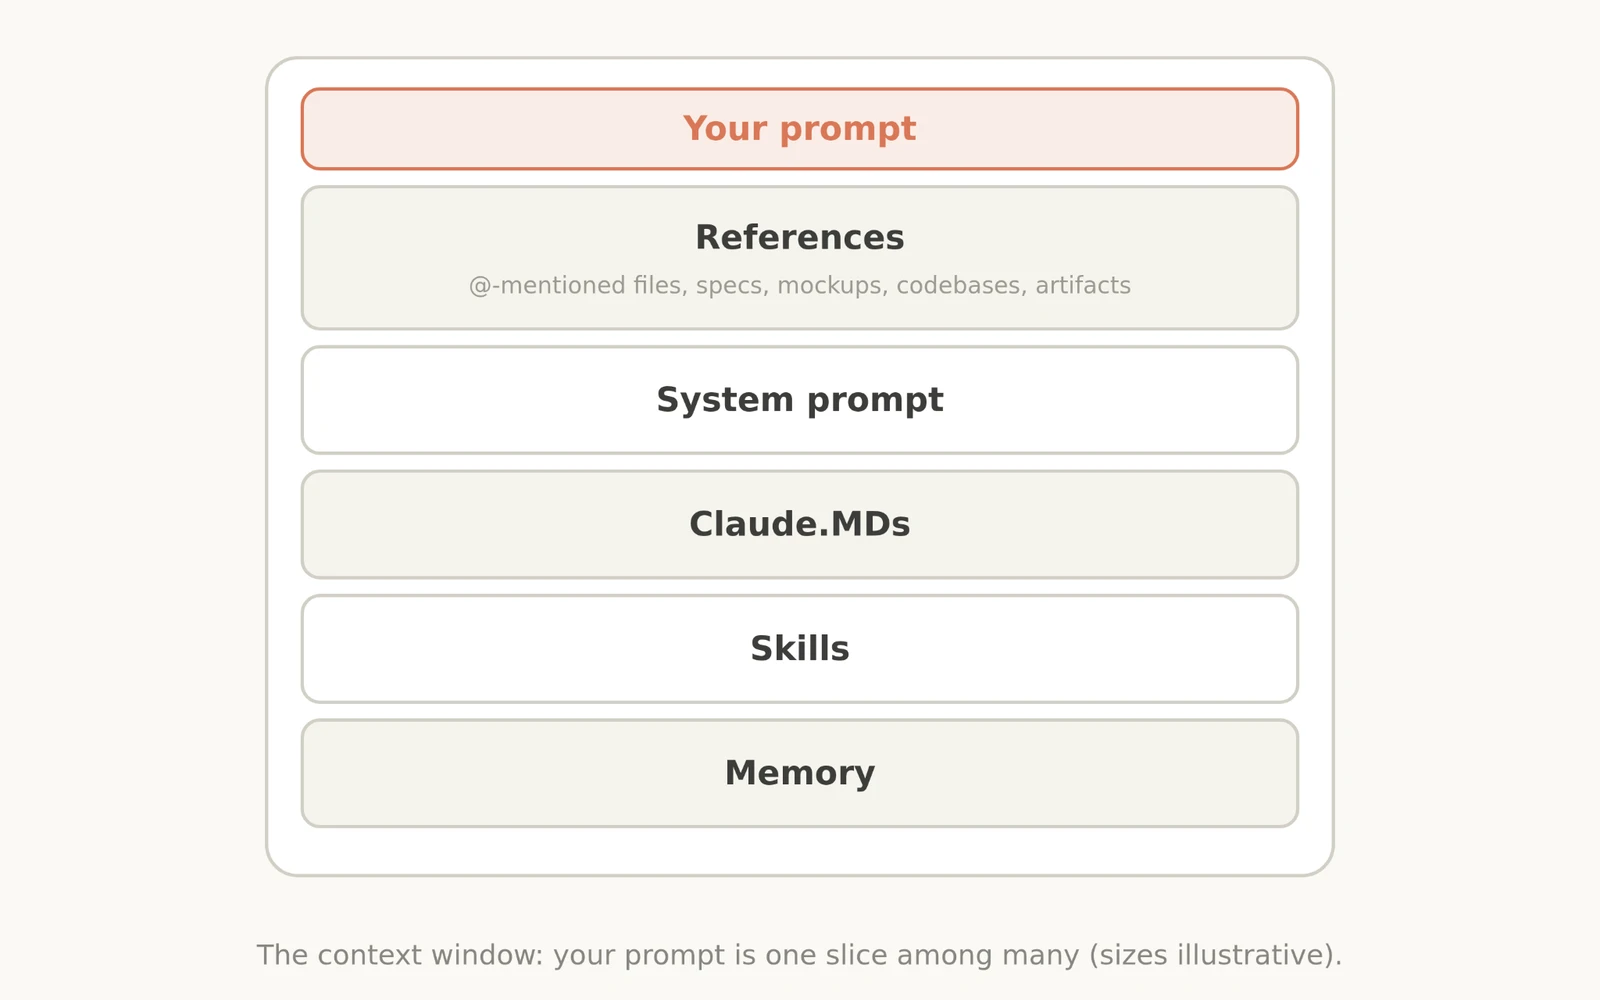
Anthropic 은 2026년 7월 Claude Code 시스템 프롬프트의 80% 이상을 삭제하고도 성능 손실이 없었다고 밝혔습니다. 그 근거가 된 컨텍스트 엔지니어링의 여섯 가지 새 규칙과 CLAUDE.md 에 넣을 것·뺄 것, AGENTS.md 효과를 두고 엇갈린 두 논문을 정리했습니다.
LLM Wiki: LLM 지식 관리 방식은 어떻게 달라지는가
문서를 잔뜩 넣어 두고 질문할 때마다 다시 뒤지는 대신, LLM이 마크다운 위키를 직접 쓰고 계속 고쳐 나가는 방식입니다. 지식이 답변 안에서 매번 새로 만들어지는 게 아니라 파일로 쌓입니다.
스펙 주도 개발은 워터폴로 돌아가는 게 아니다
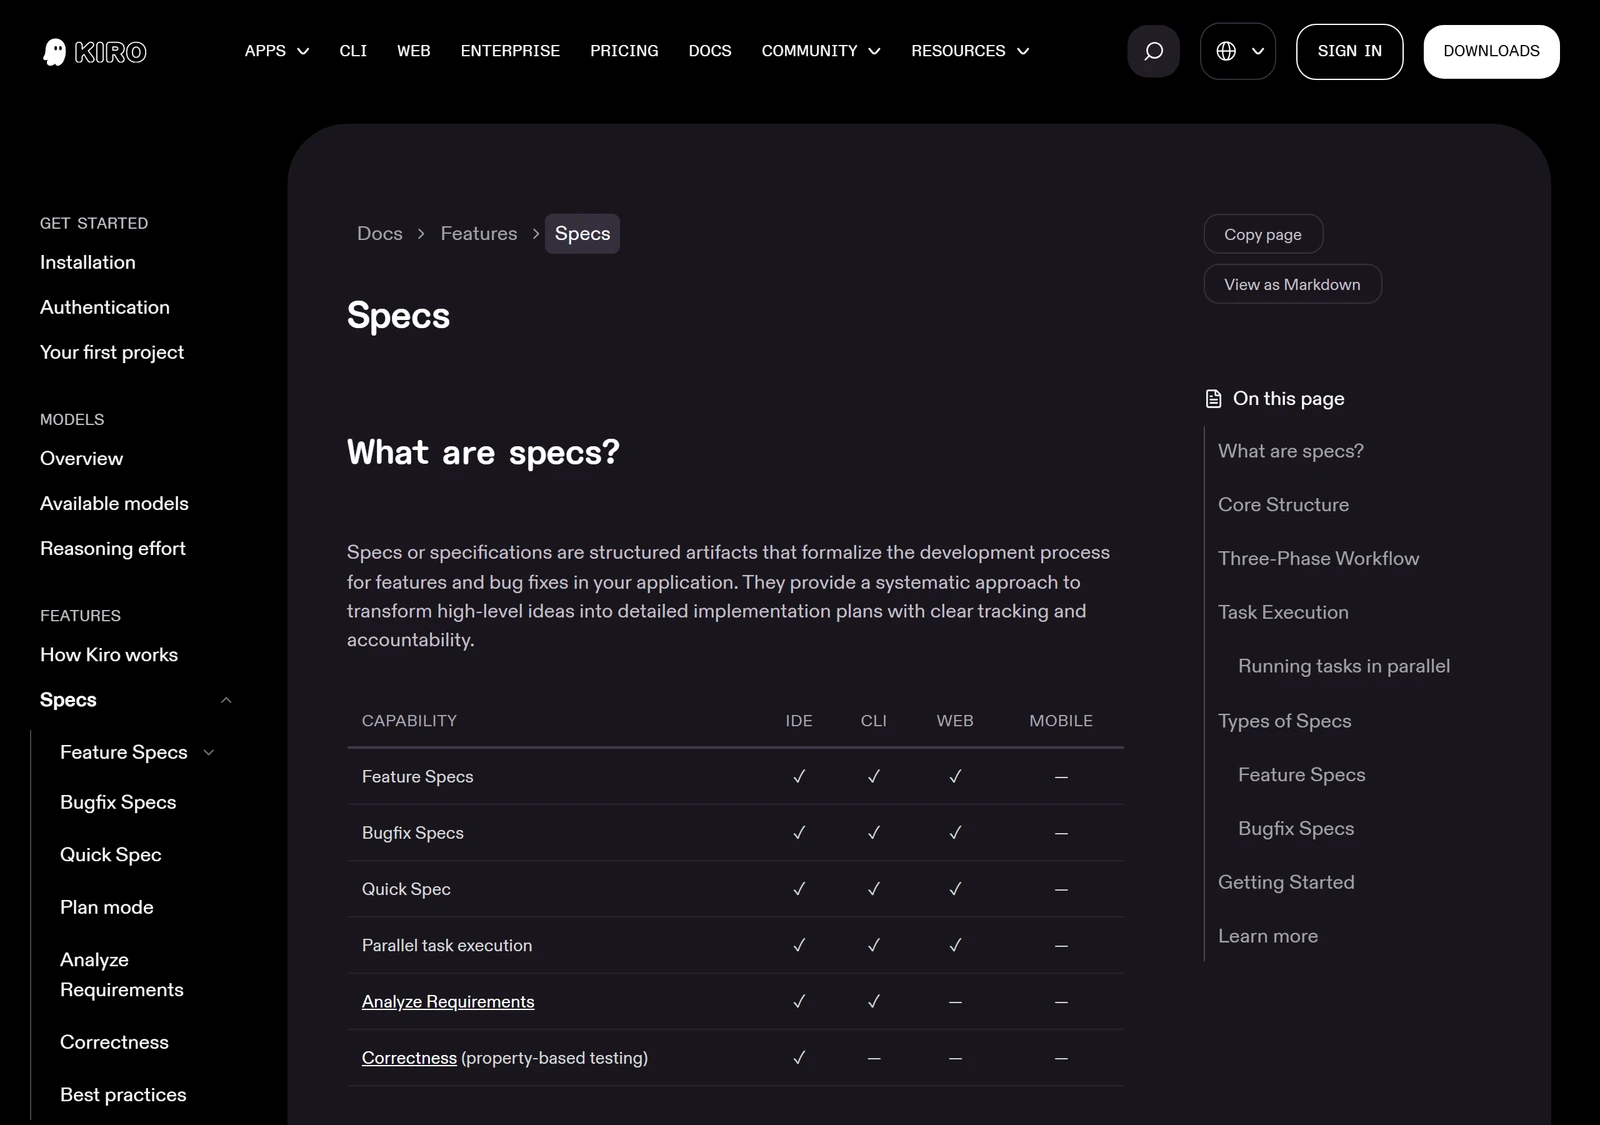
GitHub Spec Kit 은 GitHub Star 13만 7천 개를 넘었고 AWS 는 스펙을 작업 단위로 삼는 IDE Kiro 를 냈습니다. 두 도구의 구조와 Anthropic 의 스펙 작성 조언을 놓고 스펙 주도 개발이 워터폴 문서 작업과 무엇이 다른지 정리했습니다.
AI-DLC는 애자일과 뭐가 다를까요?
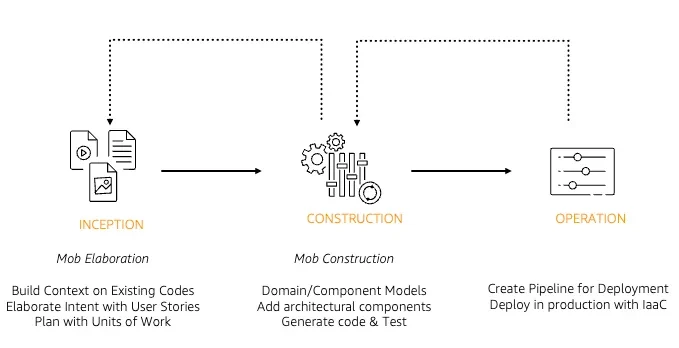
2주 스프린트가 시간·일 단위 "볼트"로 바뀌고 사용자 스토리를 AI 가 먼저 씁니다. AWS 가 2025년 7월에 제안하고 2026년 9월 현재 Claude Code·Kiro·Cursor·Copilot 에서 같은 규칙으로 돌아가는 AI-DLC 의 세 단계와 애자일과의 차이, 검증된 주장의 범위를 정리했습니다.
모든 문제에 LLM이 필요한 것은 아니다
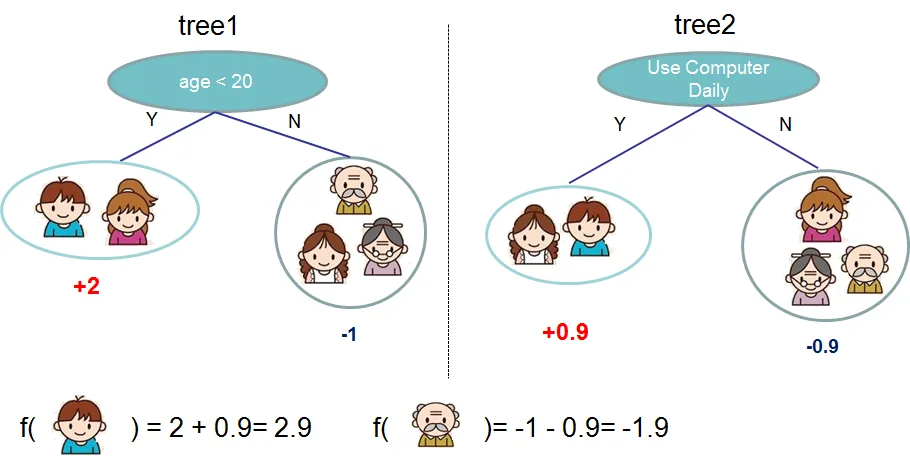
표 데이터에는 XGBoost, 시계열에는 TimesFM, 추천에는 Two-Tower. 기업 AI 프로젝트의 상당수가 LLM 이 아닌 이 세 모델로 해결되는 이유와 각각의 원리를 정리했습니다.
AI 네이티브 개발 루프는 검증이 닫는다
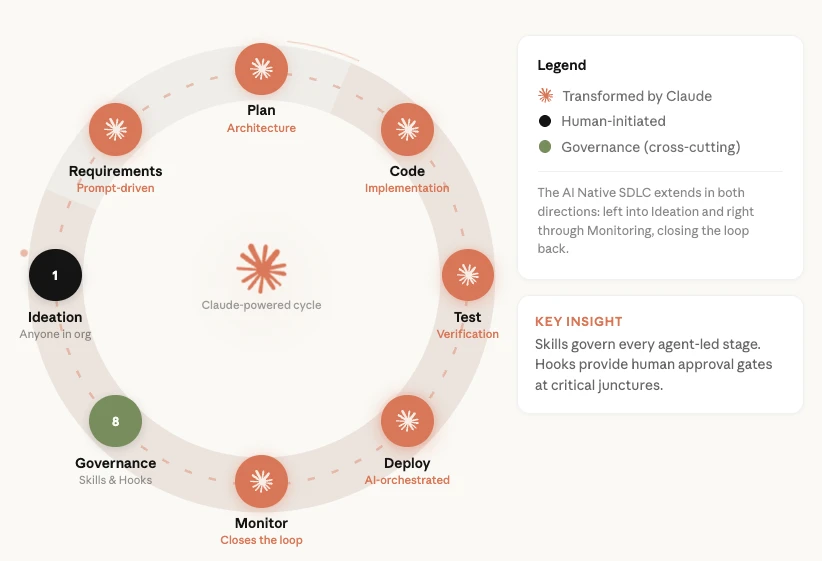
OpenAI 는 엔지니어 7명이 사람 손으로 한 줄도 안 친 100만 줄짜리 제품을 5개월 만에 만들었습니다. 그 바탕이 된 "컨텍스트 수집 → 행동 → 검증" 루프와, 사람이 앞뒤에 붙이는 탐색·계획·리뷰 단계를 Claude Code 문서와 OpenAI·Anthropic 사례로 정리했습니다.
AI 네이티브 개발, 2026년에는 뭐가 달라졌을까요?
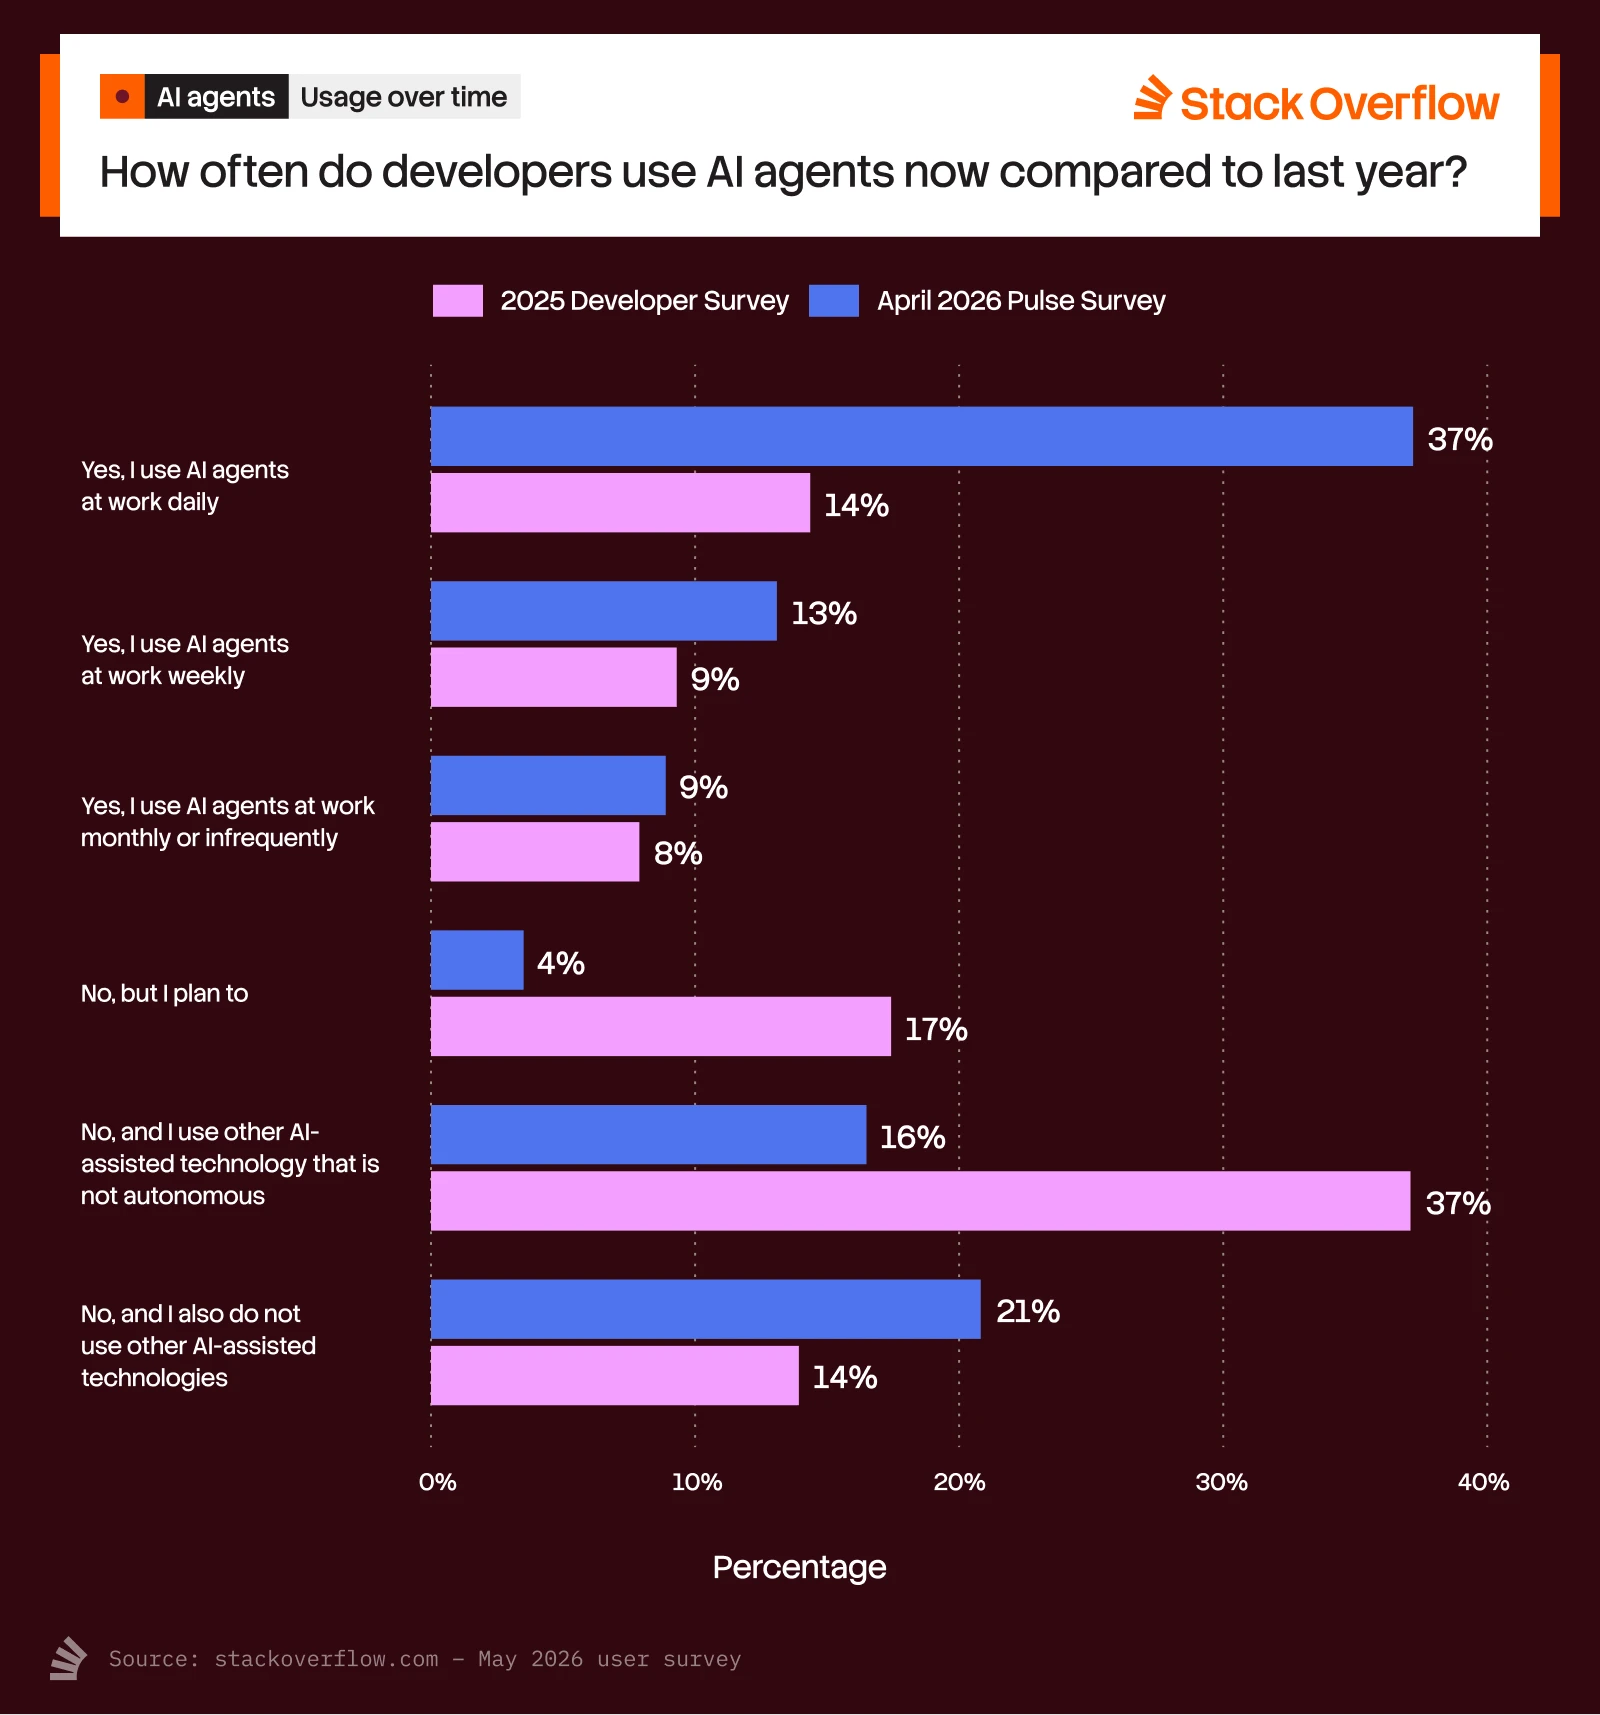
에이전트를 매일 쓰는 개발자가 1년 만에 14% 에서 37% 로 늘었고 Microsoft 에서는 CLI 에이전트를 쓴 엔지니어가 PR 을 24% 더 머지했습니다. 2026년에 나온 조사와 Karpathy·DORA·Thoughtworks 의 진단으로 "개발한다"는 말이 무엇으로 바뀌었는지 정리했습니다.
AI 시대의 데이터는 어디에 저장될까요?
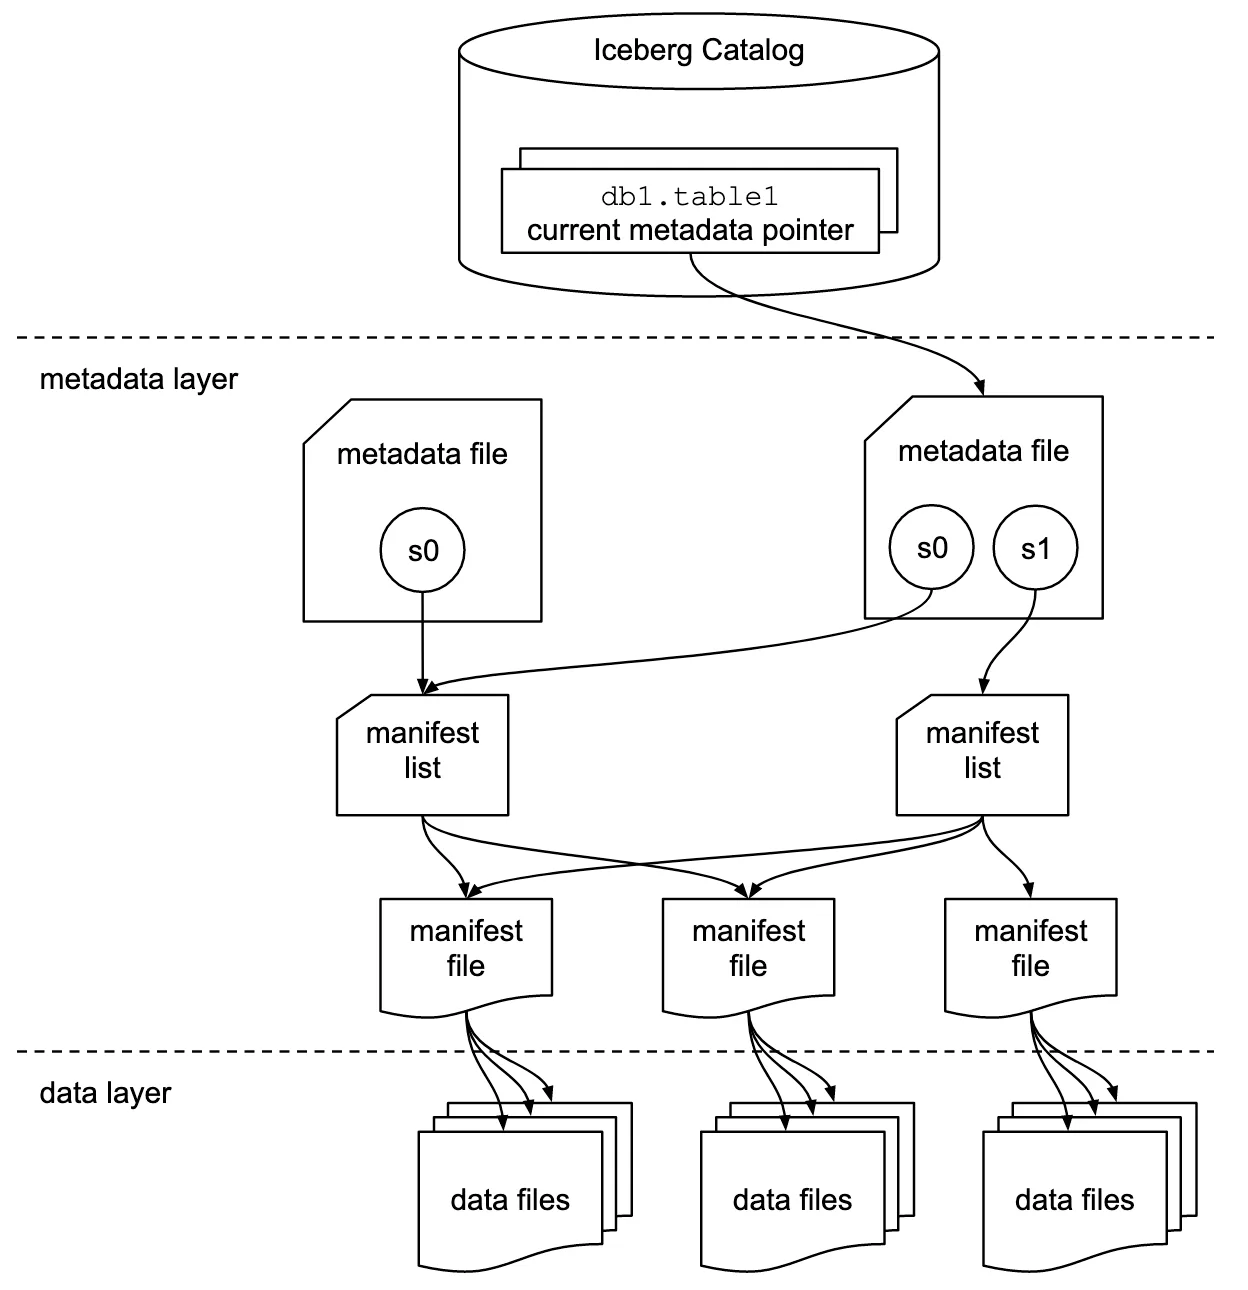
AI 에 쓰는 데이터는 DB 가 아니라 S3 에 Parquet 파일로 쌓입니다. 그 파일 더미를 테이블로 만드는 Iceberg, 큰 처리를 맡는 Spark, 빠른 질의를 맡는 StarRocks 의 역할을 한 장의 그림으로 정리했습니다.
인터넷 없는 회사에서 생성형 AI를 쓰는 방법
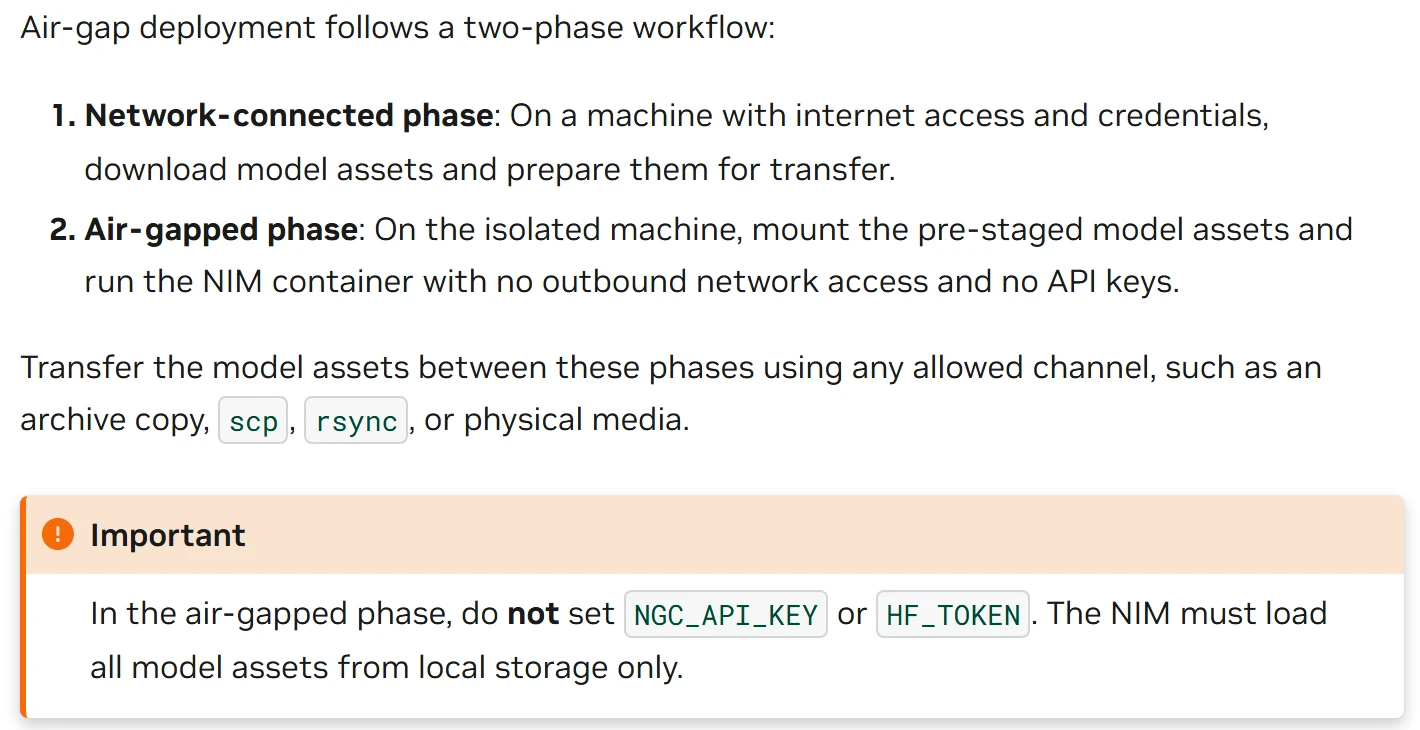
인터넷이 끊긴 폐쇄망에서도 생성형 AI 는 됩니다. LLM·임베딩 모델·벡터 DB·컨테이너 이미지·패키지를 어떻게 반입하고 들어온 뒤에는 무엇을 관리해야 하는지 정리했습니다.
RAG는 어떻게 회사 문서를 LLM에게 알려줄까요?
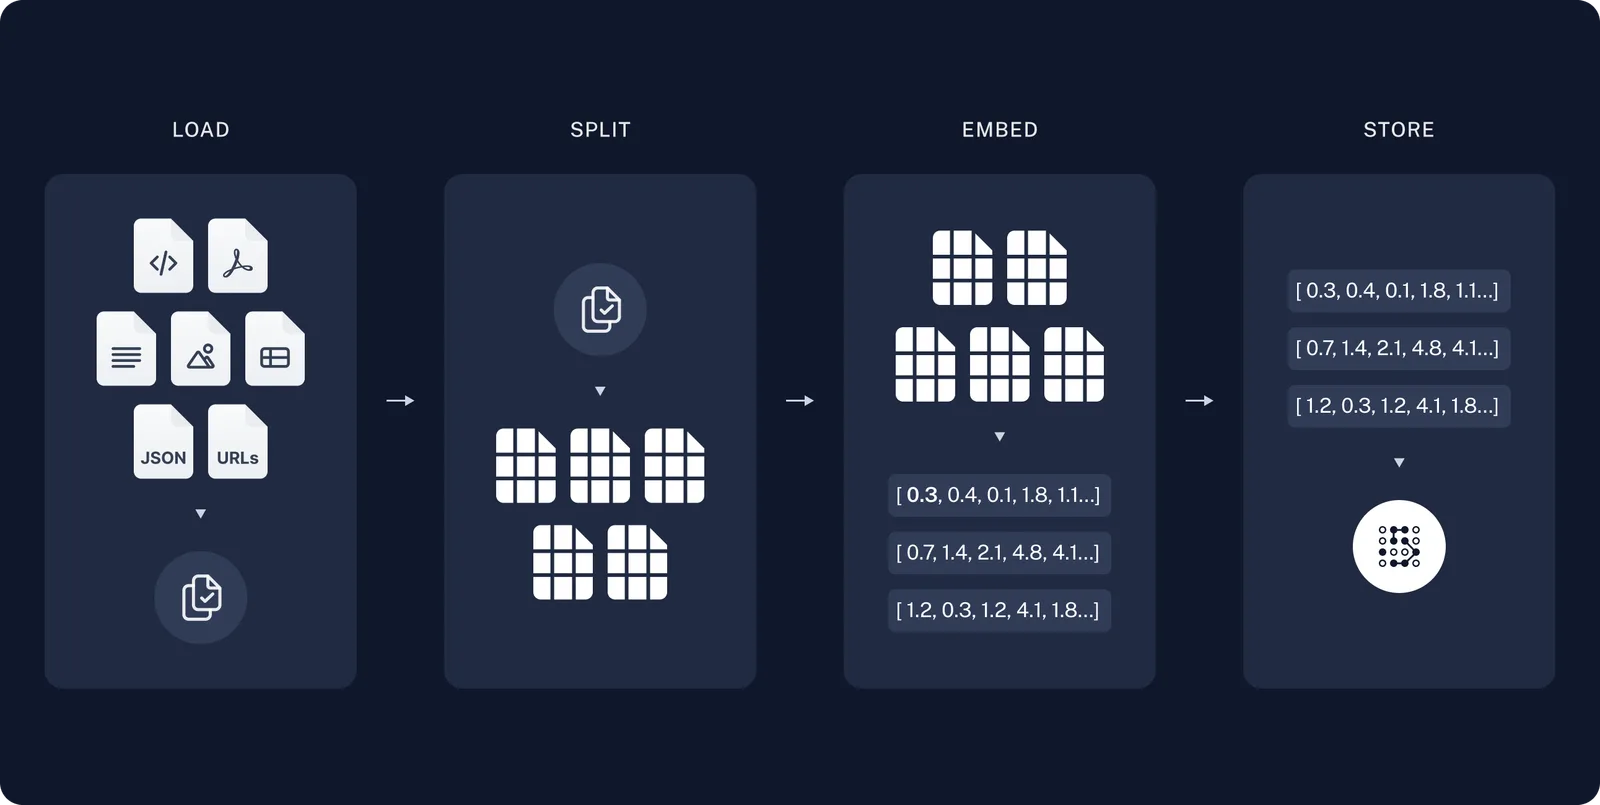
LLM 이 모르는 회사 문서를 파인튜닝 없이 답하게 만드는 RAG 의 구조 — 청킹·임베딩·벡터 DB·검색·Reranking — 를 색인과 질의 두 흐름으로 정리했습니다.
모델 전체를 다시 학습하지 않는 Fine-tuning, LoRA와 QLoRA
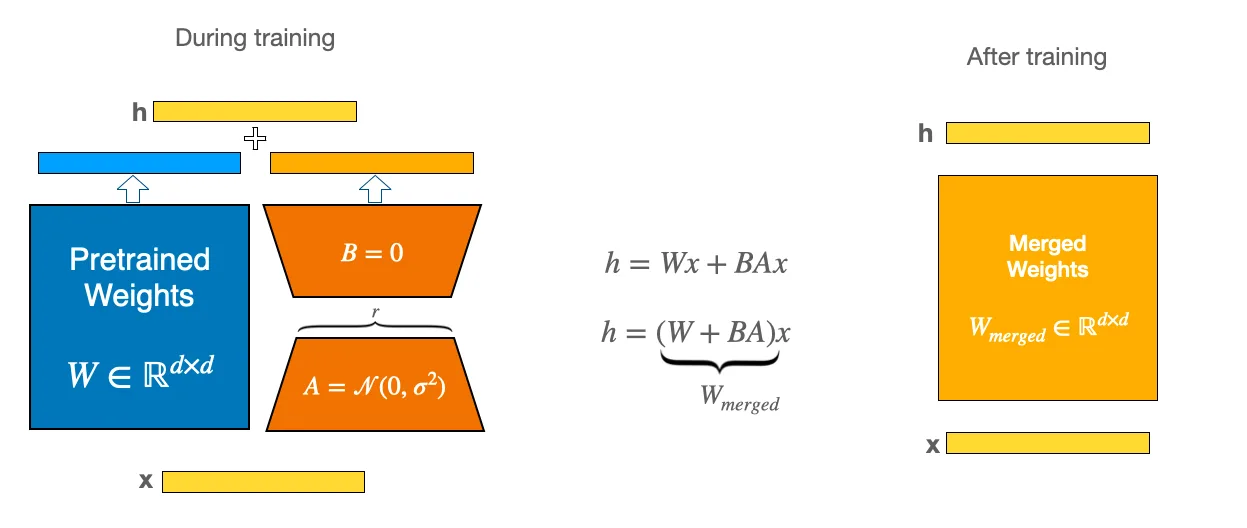
76억 개 파라미터를 전부 다시 학습하지 않고 곁에 붙인 작은 표 두 개만 학습하는 LoRA, 원본을 4비트로 눌러 놓는 QLoRA 를 실제 40.4MB 어댑터 파일로 계산해 가며 정리했습니다.
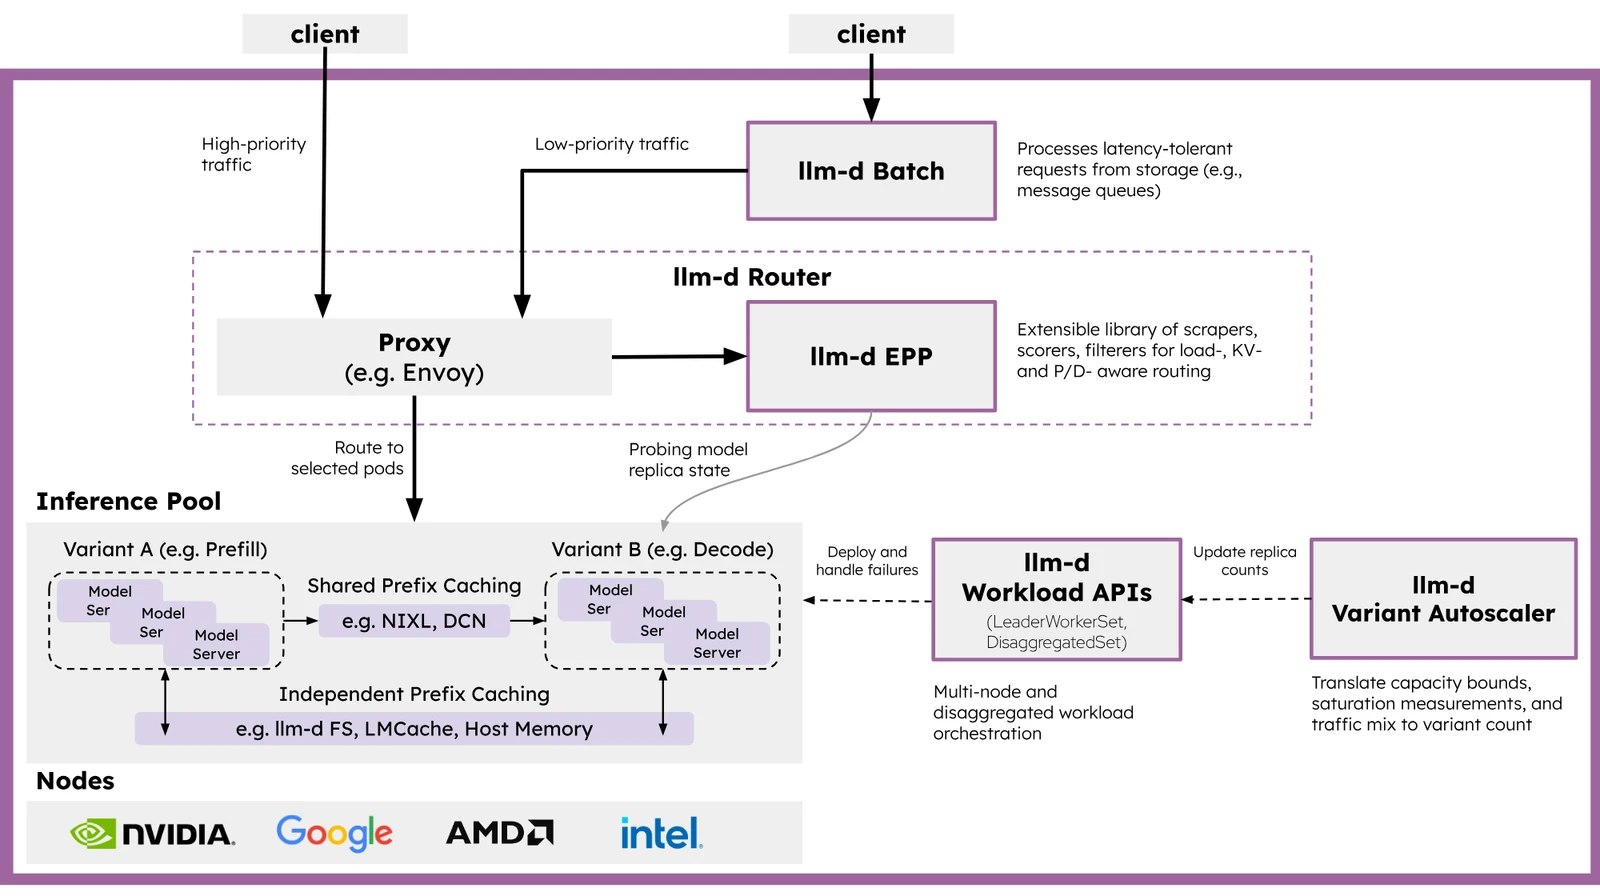
기업이 LLM을 여러 GPU에서 서비스하는 방법, Kubernetes·MIG·llm-d
모델이 GPU 한 장에 안 들어가거나, 요청이 서버 한 대를 넘거나, GPU 가 남을 때 기업이 세우는 층 — Tensor Parallel·Kubernetes·MIG·llm-d — 이 각각 무슨 문제를 푸는지 정리했습니다.
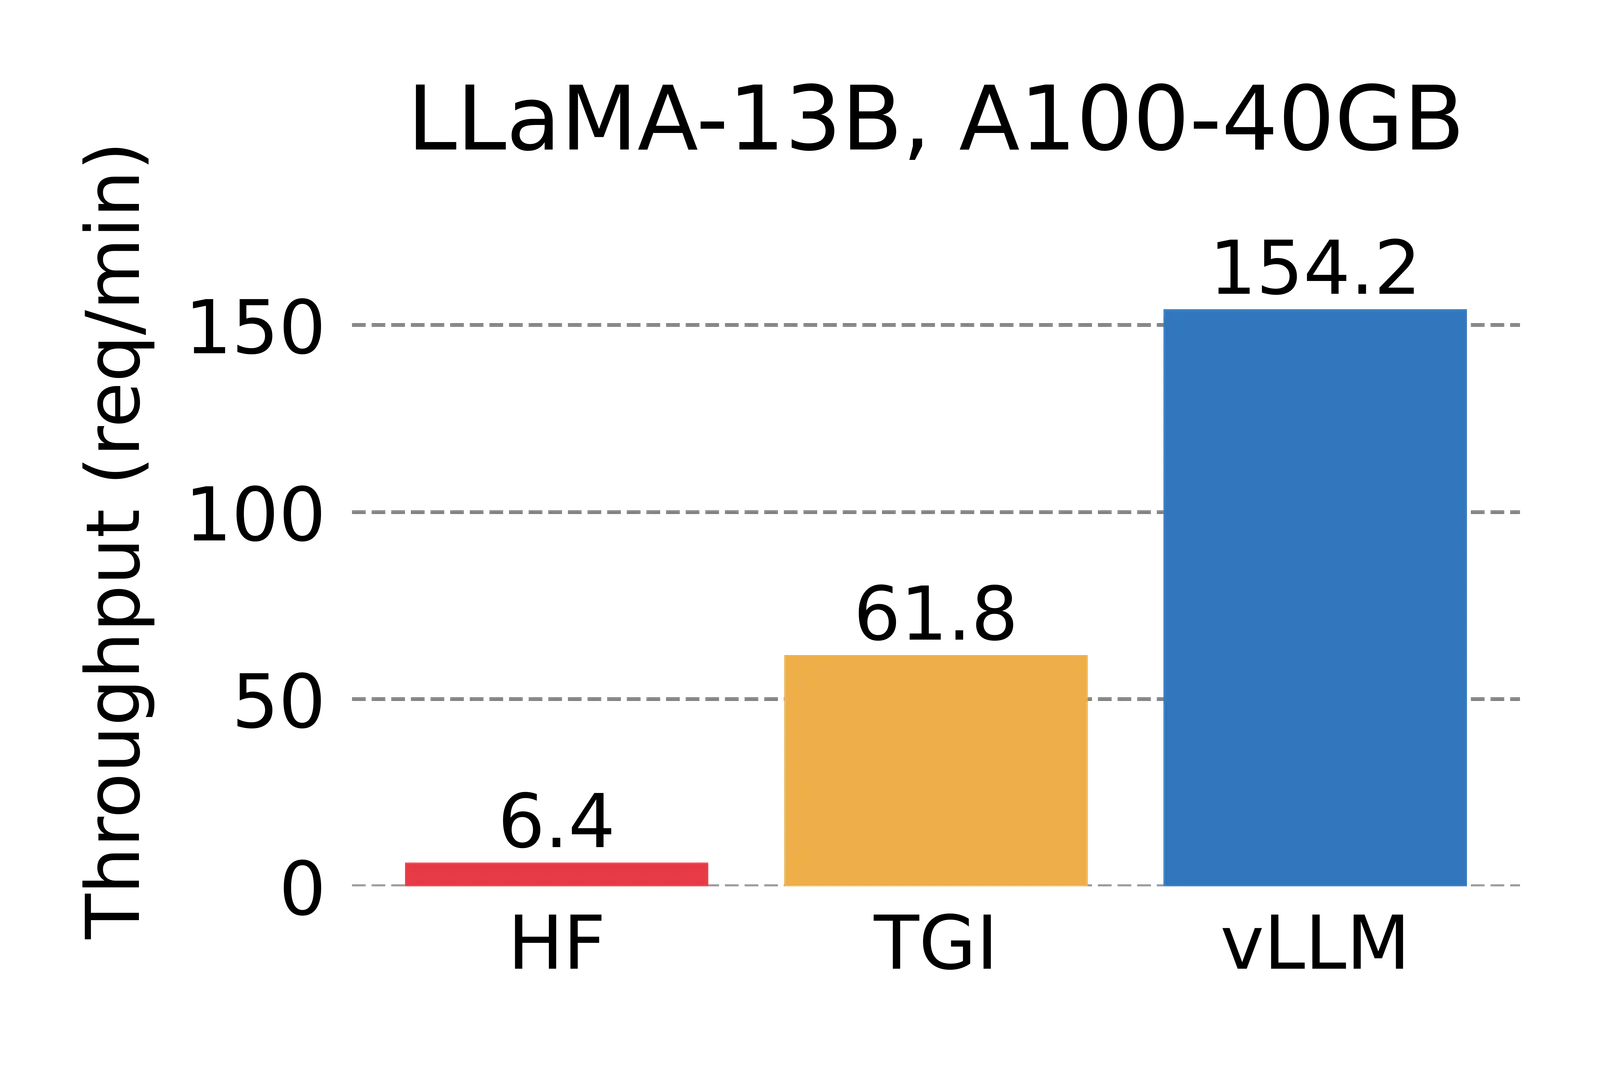
PyTorch에서 vLLM까지, LLM을 서버에 올리는 방법
model.generate() 로 잘 돌던 모델이 동시 요청 앞에서 막히는 이유와, vLLM 이 PagedAttention·Continuous Batching 으로 그 문제를 어떻게 푸는지 코드와 함께 정리했습니다.
Claude 신규 모델 Fable 5 공개
Anthropic이 2026년 6월 9일 신규 모델 Claude Fable 5를 공개했습니다. Mythos는 보안 문제로 일반 공개가 미뤄졌었고, 안전장치를 달고 나온 모델이 Fable 5입니다. 사이버보안·생물·화학처럼 위험한 요청이 들어오면 응답을 막고, 한 단계 아래인 Claude Opus 4.8로 모델을 바꿔 답한다고 합니다.
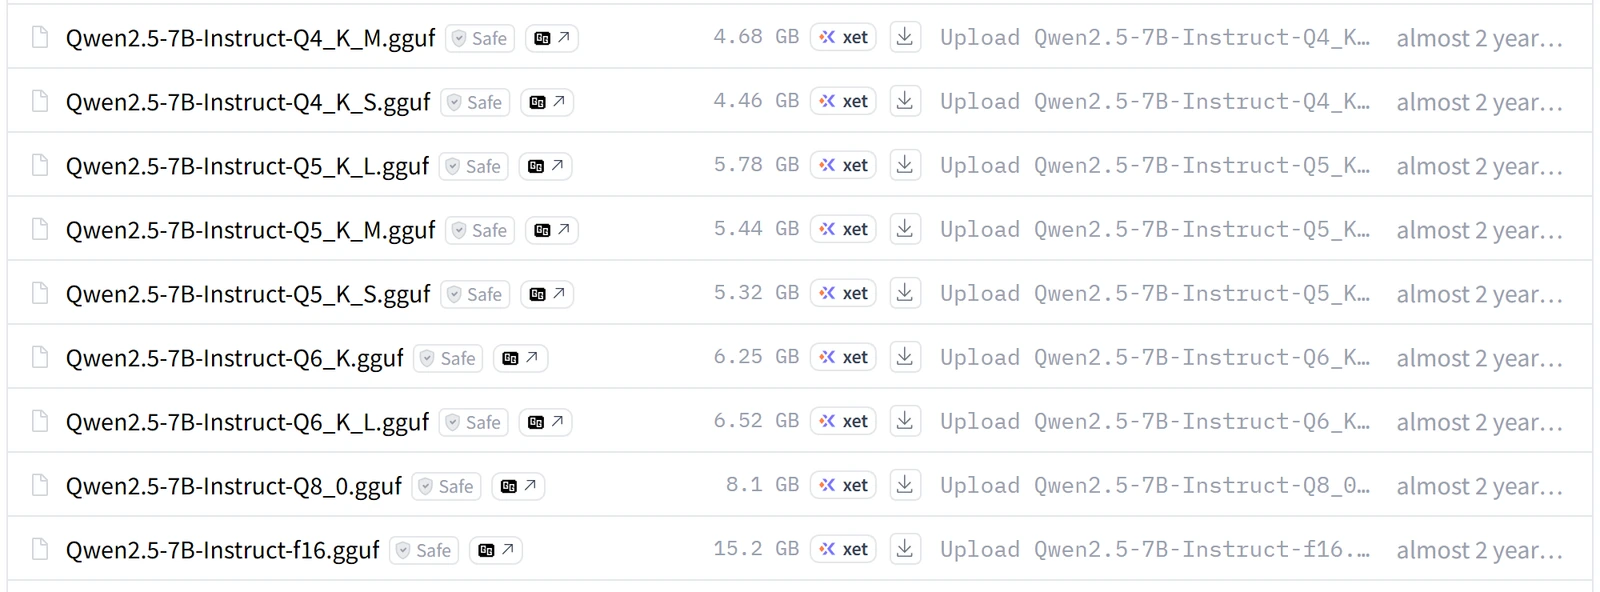
7B 모델에 GPU 메모리 14GB가 필요한 이유
같은 7B 모델이 15.2GB 짜리도 있고 4.68GB 짜리도 있는 이유는 숫자 하나를 몇 바이트로 적느냐가 다르기 때문입니다. FP16·BF16·INT8·INT4 의 차이와 양자화의 원리, 그리고 7B 모델의 VRAM 을 직접 계산해 봅니다.
LLM 답변은 왜 첫 글자만 늦게 나올까요?
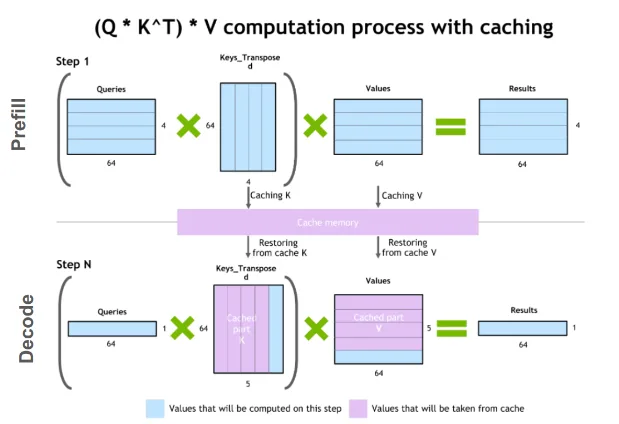
챗봇 답변의 첫 글자만 늦는 이유는 답을 만드는 과정이 Prefill 과 Decode 두 단계로 나뉘고 병목이 서로 다르기 때문입니다. 둘 사이의 KV Cache 가 왜 필요하고 얼마나 큰지, TTFT·Tokens/sec 가 뭘 재는지 정리했습니다.
단순 지식을 넘어 '진짜 노하우'로: AI 에이전트에 온톨로지를 깔다
산업 특화 AI 에이전트로 매출 100억, 50개국 진출. 인핸스 이승현 창업자는 EO 인터뷰에서 그 핵심으로 LLM이 아니라 온톨로지를 짚었습니다. 도메인 지식을 지식 그래프로 정리해 에이전트 위에 깔자, 그제야 에이전트가 안정적으로 일하기 시작했다고 합니다.
LLM이 문장을 읽는 순서, 토큰·임베딩·Attention
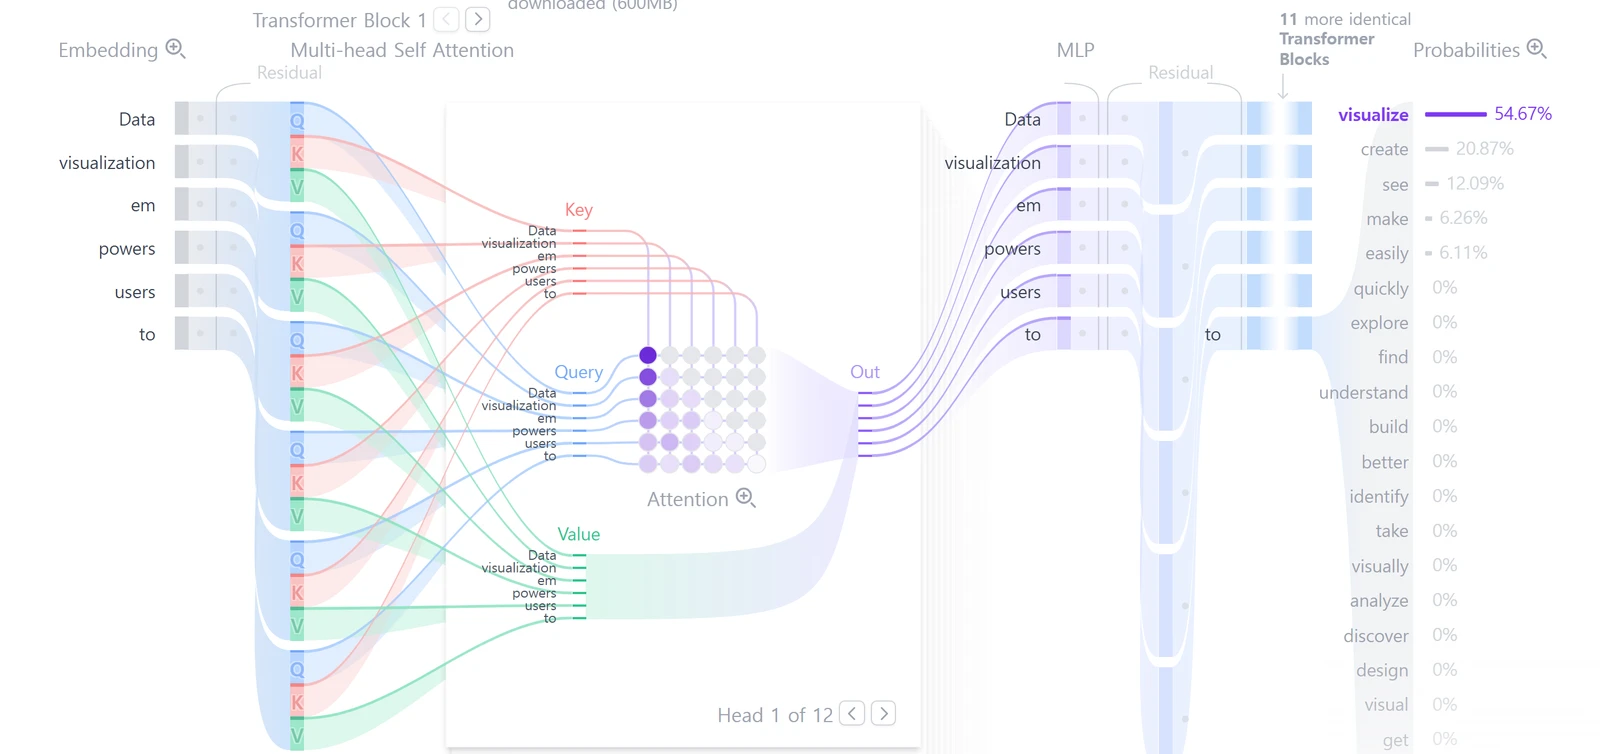
모델 파일 안의 숫자 표가 문장을 읽는 순서 — 토큰으로 자르고 임베딩으로 벡터를 만들고 Attention 으로 관계를 계산해 다음 토큰 하나를 고르기까지 — 를 Transformer Explainer 화면과 함께 따라갑니다.
'프로그래머로서 가장 뒤처졌다' — Vibe Coding 다음은 Agentic Engineering
Andrej Karpathy가 Sequoia AI Ascent 2026에서 "vibe coding" 1년을 정리하면서 다음 단계인 agentic engineering의 윤곽을 풀어냈습니다. 작년에는 누구나 만들 수 있도록 바닥을 올렸다면, 올해는 잘하는 사람의 천장이 깨지는 중이라는 진단이죠.
LLM 모델 뒤에 붙는 B가 뭘까요?
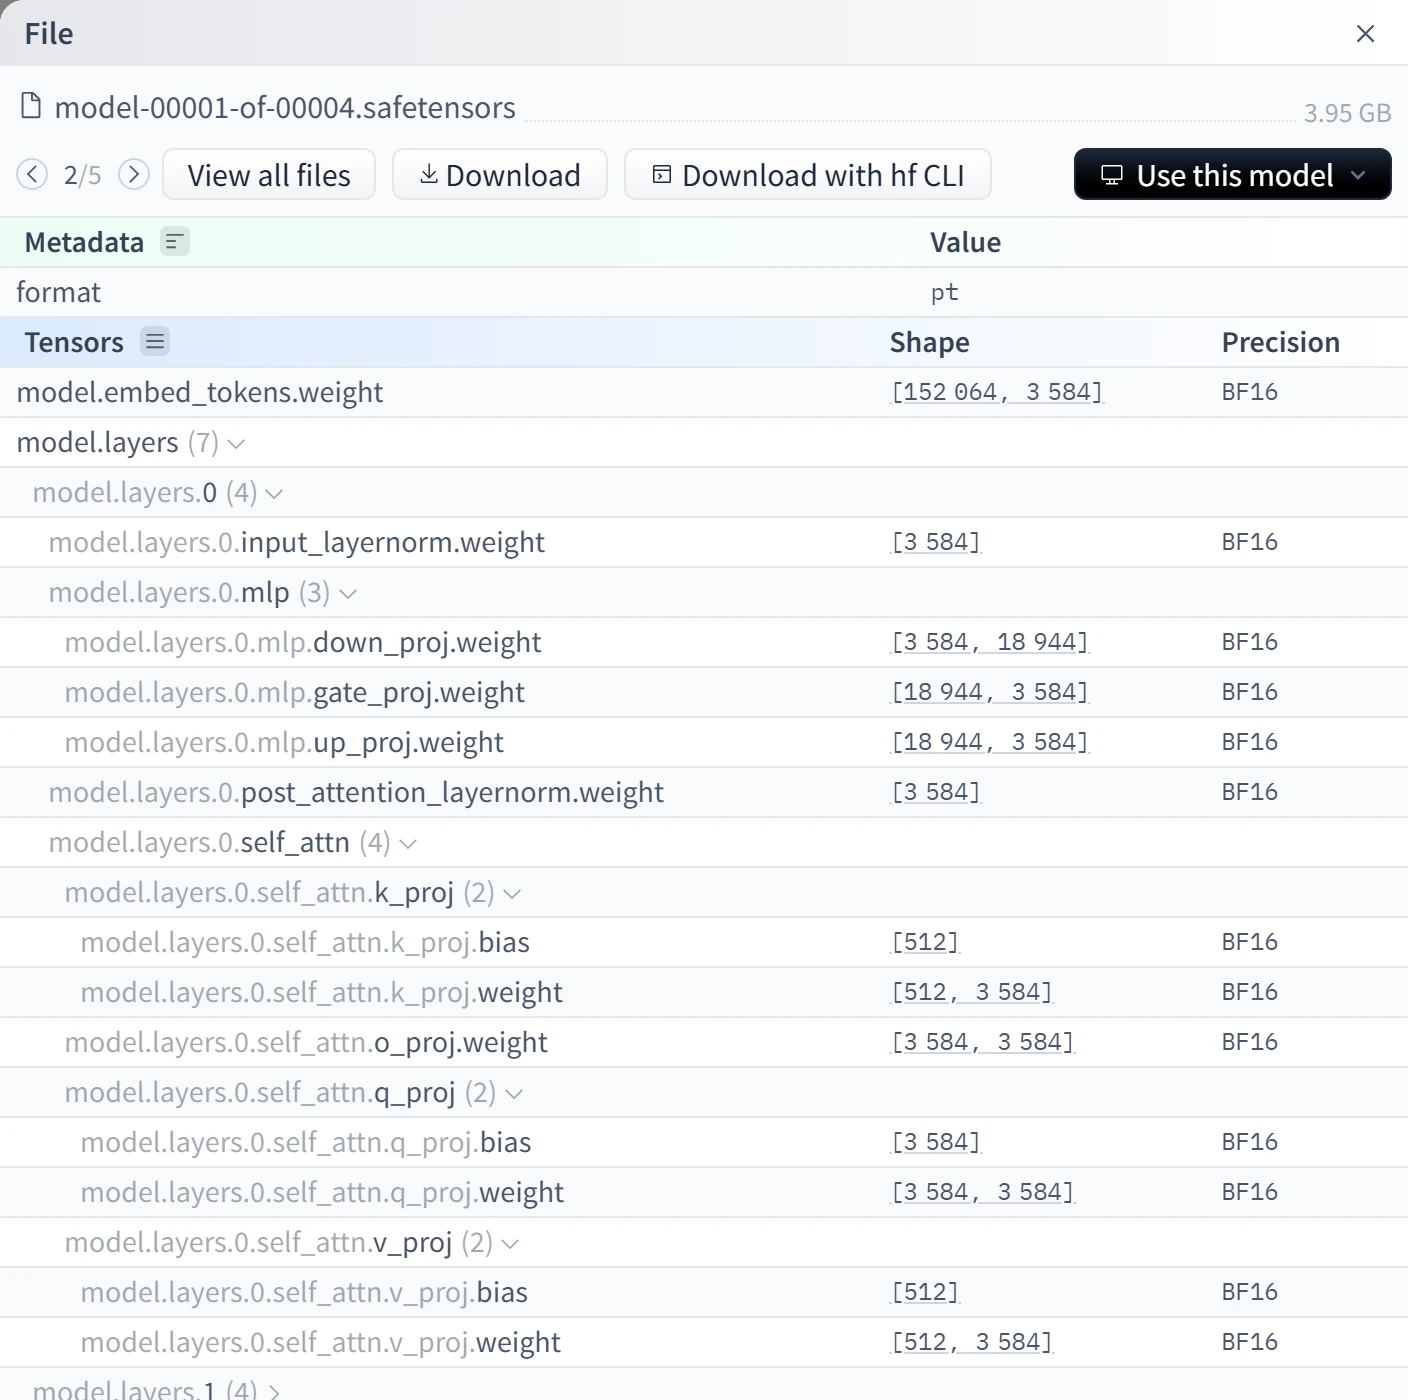
Hugging Face 모델 이름 뒤에 붙는 7B·70B 의 B 는 파라미터 개수입니다. 그 76억 개 숫자가 파일 어디에 어떻게 들어 있는지 실제 모델 파일을 열어 확인하고 학습·추론·벡터 DB 와 어떻게 이어지는지 정리했습니다.